
OpenMOSS · صدر في 16 أكتوبر 2026 · Apache 2.0
MOSS-Image: النموذج المفتوح للنصوص والتخطيطات داخل الصور
MOSS-Image نموذج مفتوح الأوزان لتحويل النص إلى صورة بحجم 5B من OpenMOSS، يكتب نصوصًا صينية وإنجليزية طويلة داخل الصور ويتبع تخطيطات JSON. ستجد أدناه مواصفاته ودرجات اختباراته المعيارية وصورًا من إنتاجه وطريقة تشغيله.
يعمل MOSS-Image على بطاقة GPU لديك، لذا لا يستضيفه Nano AI. والنموذج الذي يُقارَن به في أغلب الأحيان هو Qwen Image 2.1، وهو يركّز بالقدر نفسه على النصوص الصينية والإنجليزية داخل الصور. وهذا هو النموذج الذي يشغّله هذا المولّد: 8 أرصدة لكل صورة، دون حاجة إلى GPU.
16 رصيدًا مجانيًا = صورتان قياسيتان. دون بطاقة.
لوحة النتائج
ستظهر النسخ التي تنشئها هنا.
- المطوّر
- OpenMOSS
- تاريخ الإصدار
- 16 أكتوبر 2026
- المتاح على Nano AI
- Qwen Image 2.1 · 8 رصيد لكل صورة
- آخر تحديث للصفحة
- 20 أكتوبر 2026
المصدر: github.com
ما هو MOSS-Image؟
MOSS-Image نموذج لتحويل النص إلى صورة أصدرته OpenMOSS (MOSI.AI) في 16 أكتوبر 2026، بمشاركة باحثين من جامعة فودان وجامعة شنغهاي جياو تونغ ومعهد شنغهاي للابتكار (Shanghai Innovation Institute). ويجمع بين محوّل انتشار (diffusion transformer) من 5 مليارات معامل دُرِّب من الصفر، ونموذج اللغة Qwen3.5-9B بوصفه مُرمِّزًا للنصوص، و FLUX.2 VAE.
ويأتي في نسختين (checkpoints): تُركت MOSS-Image-Base دون تدريب لاحق ليسهل ضبطها ضبطًا دقيقًا، أما MOSS-Image-SFT فخضعت لضبط دقيق على بيانات منتقاة لتخرج النصوص والتخطيطات أنظف. وكلتاهما صادرتان بترخيص Apache 2.0 الذي يسمح بالاستخدام التجاري.
يقتصر MOSS-Image على تحويل النص إلى صور: إذ يذكر تقريره التقني أنه لا يقبل صورًا مرجعية ولا يعدّل الصور. ولاستخدامه تنزّل الأوزان، نحو 13 GB بملفات ComfyUI الأصغر حجمًا أو 27 GB بالدقة الكاملة، ثم تشغّلها في ComfyUI أو Diffusers أو SGLang أو vLLM-Omni. وإن كنت تريد صورًا بنصوص صينية وإنجليزية واضحة فحسب، فالمولّد أعلى هذه الصفحة يشغّل Qwen Image 2.1 في المتصفح.
مواصفات MOSS-Image
- المطوّر
- OpenMOSS (MOSI.AI)
- تاريخ الإصدار
- 16 أكتوبر 2026
- الترخيص
- Apache 2.0، ويسمح بالاستخدام التجاري
- نموذج الصور
- محوّل انتشار أحادي المسار (single-stream) بحجم 5B، من 42 كتلة
- مُرمِّز النصوص
- Qwen3.5-9B (مُجمَّد)
- VAE
- FLUX.2 VAE مع مفكّك الترميز (decoder) الصغير
- النسخ (checkpoints)
- MOSS-Image-Base و MOSS-Image-SFT
- صيغ الأوصاف النصية
- لغة طبيعية، وقوائم وسوم، وتخطيطات JSON (تجريبية)، حتى 4,096 رمزًا (token)
- الدقة
- يُوصى بـ 1 إلى 2 ميغابكسل؛ من 512 × 512 حتى 2K، وطول كل ضلع من مضاعفات 16
- تعديل الصور
- غير مدعوم
- إعدادات أخذ العينات الافتراضية
- Euler، 50 خطوة، CFG 3، shift 5، تخطي الطبقة 22 (skip layer)
- على Nano AI
- غير مستضاف؛ يعمل Qwen Image 2.1 بدلًا منه، 8 أرصدة لكل صورة
أمثلة من MOSS-Image
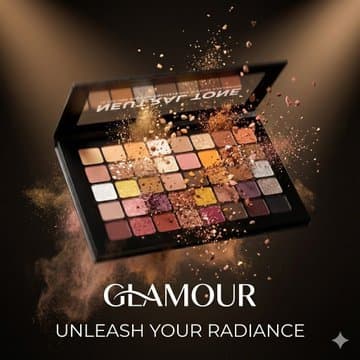
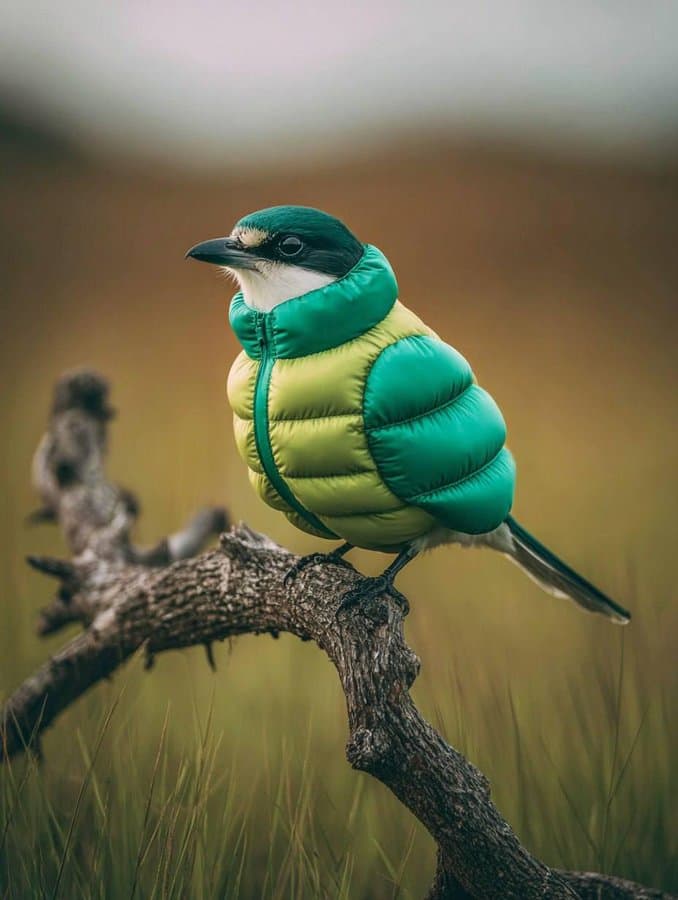
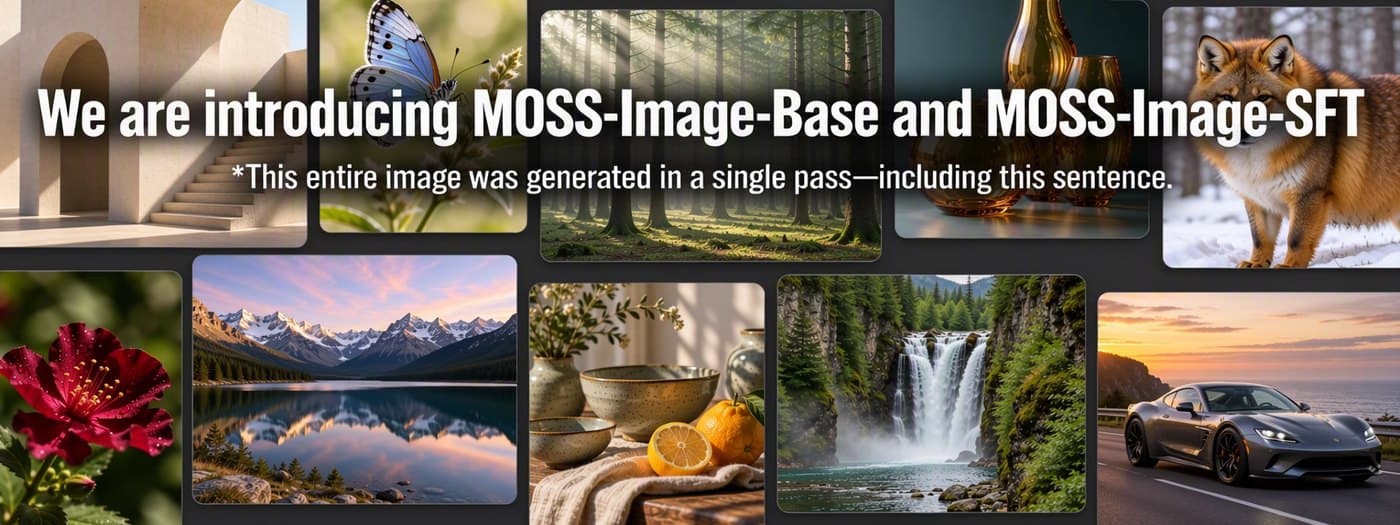
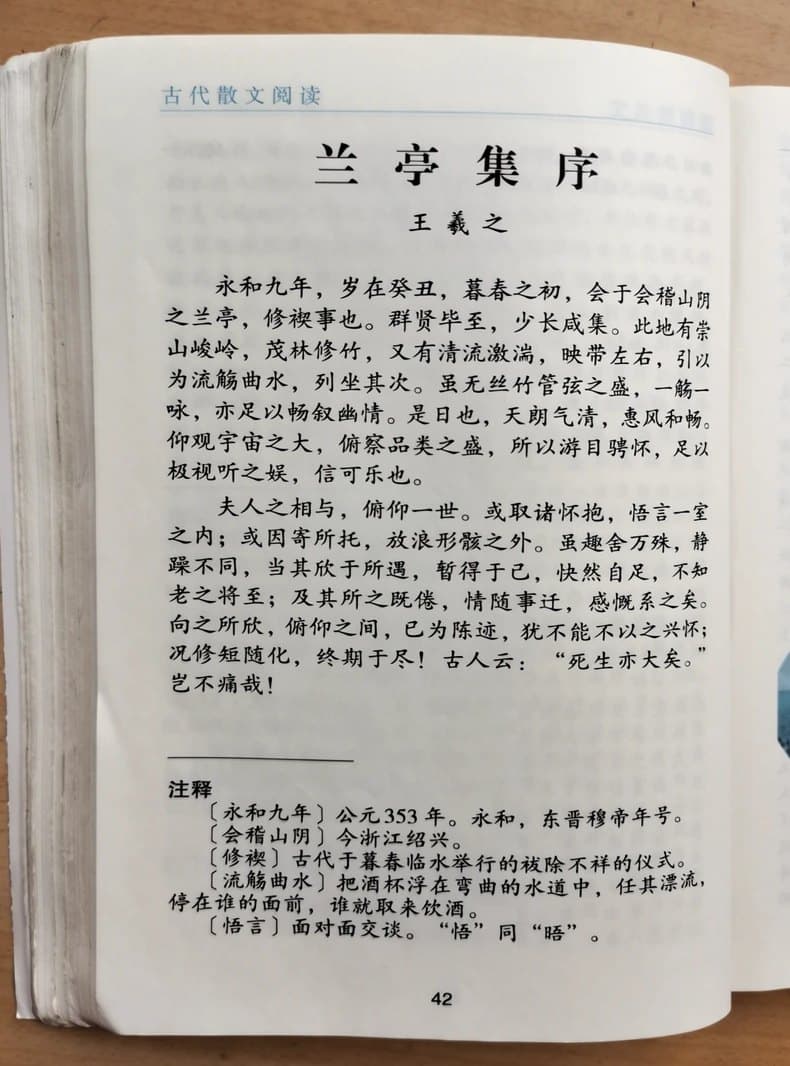
مقتطعة من صور العرض في بطاقة نموذج OpenMOSS ودون أي تنقيح. لم تنشر OpenMOSS الأوصاف النصية، لذا يصف التعليق تحت كل صورة محتواها بدلًا منها.
ما يجيده MOSS-Image وأين يتعثّر
نصوص طويلة تُقرأ بشكل صحيح
في اختبار النصوص الطويلة الخاص بـ OpenMOSS (LLTB) يسجّل MOSS-Image درجة 96.3، فيضاهي Nano Banana Pro الذي سجّل 96.6، ويتقدّم بفارق كبير على نماذج مفتوحة مثل Qwen Image 2512 (64.9) و Z-Image Base (40.8). ويفيد المختبِرون بقلة الأخطاء الإملائية في الإنجليزية واليابانية.
تخطيطات تُحدَّد بالإحداثيات
يستطيع وصف نصي بصيغة JSON أن يخصّص لكل كتلة نصية ولكل عنصر مربّعًا خاصًا به. وفي اختبار التخطيط 7Bench يبلغ MOSS-Image قيمة 0.88 mIoU، مقابل 0.30 إلى 0.33 لكلٍّ من GPT Image 2 و Nano Banana Pro و Seedream 5.0 Pro و Qwen Image 3.0 Pro.
صغير بما يكفي لبطاقة GPU استهلاكية واحدة
مع ملفات 8 بت عمل النموذج ذو الحجم 5B على بطاقة RTX 4070 بذاكرة 12 GB في اختبارات المجتمع، وتعمل نسخ 4 بت أو GGUF على بطاقات 8 GB مع تفريغ جزء من الحمل إلى ذاكرة النظام (offloading).
مصمَّم للضبط الدقيق
يأتي نموذج Base دون تدريب لاحق. وتدعم أداتا KohakuMossTrainer و DiffSynth-Studio تدريب LoRA عليه بالفعل، ونشر المجتمع نسخًا تعمل بـ 8 خطوات و4 خطوات.
بطيء بالإعدادات الافتراضية
تستغرق 50 خطوة، كلٌّ منها بتمريرتين، نحو 27 ثانية لكل صورة 1024 × 1024 على RTX 5090 بالدقة الكاملة، ونحو 50 ثانية على RTX 4070 بذاكرة 12 GB مع ملفات 8 بت.
نقاط ضعف معروفة
يفيد المستخدمون بظهور أشرطة لونية عمودية في صور SFT، وخلفيات ضبابية، وأيدٍ مشوّهة، ونصوص إضافية لم يطلبها أحد، وصعوبة في العدّ. ولا يستطيع النموذج تعديل الصور.
MOSS-Image مقابل Qwen Image 2.1 و Nano Banana Pro و GPT Image 2
درجات الاختبارات مأخوذة من التقرير التقني لـ MOSS-Image (arXiv 2610.23374)، وقد أجرتها OpenMOSS بنفسها؛ ولم يكن Qwen Image 2.1 ضمنها. والأرصدة هي أسعار Nano AI في 20 أكتوبر 2026.
| MOSS-Image | Qwen Image 2.1 | Nano Banana Pro | GPT Image 2 | |
|---|---|---|---|---|
| المطوّر | OpenMOSS | Alibaba | OpenAI | |
| الأوزان | مفتوحة، Apache 2.0 | مفتوحة | مغلقة | مغلقة |
| درجة النصوص الطويلة (LLTB) | 96.3 | لم يُختبر | 96.6 | 99.0 |
| درجة Elo للتفضيل البشري (RLA) | 1698.7، باستخدام مُحسِّن أوصاف نصية يعتمد على GPT-6 | لم يُختبر | 1590.2 | 1844.4 |
| تعديل الصور | لا | نعم | نعم | نعم |
| أين تشغّله | على GPU لديك | Nano AI، 8 أرصدة | Nano AI، 32 رصيدًا | Nano AI، 12 رصيدًا |
طريقة تشغيل MOSS-Image
- 1
في ComfyUI
حدّث ComfyUI إلى الإصدار 0.42.0 أو أحدث، ونزّل نموذج الانتشار ومُرمِّز النصوص Qwen3.5-9B و FLUX.2 VAE من Comfy-Org/MOSS-Image، ثم افتح أحد قوالب MOSS-Image. ويسرد دليل ComfyUI MOSS-Image الخاص بنا، المرتبط أدناه، كل ملف وكل إعداد.
- 2
باستخدام Python
على GPU من NVIDIA، ثبّت diffusers 0.38 أو أحدث، وحمّل OpenMOSS-Team/MOSS-Image-SFT مع خط المعالجة المخصّص (custom pipeline) المرفق به. ويمكن أيضًا تشغيل النموذج كخدمة (serving) عبر SGLang و vLLM-Omni.
- 3
دون GPU
جرّب العرض التجريبي المجاني من OpenMOSS على Hugging Face Spaces، وقد تنتظر فيه دورك، أو المولّد أعلى هذه الصفحة الذي يشغّل Qwen Image 2.1، النموذج الذي يُقارَن به MOSS-Image في أغلب الأحيان.
نصائح لكتابة الأوصاف النصية في MOSS-Image
اكتب بالإنجليزية متى استطعت، فهي اللغة التي تحظى بأكبر قدر من بيانات التدريب، وضع الكلمات المطلوبة حرفيًا بين علامتي تنصيص، وأضف فواصل الأسطر حيث تريدها. وتعمل الأوصاف الأربعة الأولى أيضًا في المولّد أعلاه.
ملاحظة بخط اليد بالصينية
A wide view of a refrigerator beside a kitchen counter with a fruit bowl. A small sticky note on the refrigerator door is handwritten in Chinese: "记得买牛奶和鸡蛋! 牛奶两盒,鸡蛋一打。 顺便带一袋面包。"
لافتة متجر بلغتين
A small tea shop at dusk with a wooden sign that reads "山间茶舍" on the first line and "Mountain Tea House" on the second line, warm lantern light, wet stone steps, no people
ملاحظات على سبورة بيضاء
A glass whiteboard in a bright office with neat handwritten notes in blue marker: "Q4 plan 1. Ship the layout editor 2. Train a style LoRA 3. Publish the user guide", soft daylight, no people
عنوان ملصق
A minimalist travel poster with a cream background, a blue mountain illustration, and the title "EXPLORE" at the top.
قائمة وسوم (MOSS-Image)
best quality, highres, scenery, mountain lake, sunrise, mist, no humans
الأسئلة الشائعة
الأسئلة الشائعة حول MOSS-Image
إجابات مختصرة عن النموذج وطريقة تشغيله واستخدام نموذج مشابه أونلاين.
هل MOSS-Image مجاني؟
نعم. الأوزان والشيفرة البرمجية مجانية بموجب ترخيص Apache 2.0، بما في ذلك للاستخدام التجاري. ولا تدفع إلا تكلفة GPU الذي تشغّله عليه. وتستضيف OpenMOSS أيضًا عرضًا تجريبيًا مجانيًا على Hugging Face Spaces.
هل يمكنني استخدام MOSS-Image أونلاين دون GPU؟
العرض التجريبي من OpenMOSS على Hugging Face هو الخيار الرسمي الوحيد، وقد تنتظر فيه دورك. لا يستضيف Nano AI نموذج MOSS-Image؛ فالمولّد في هذه الصفحة يشغّل Qwen Image 2.1، وهو قريب منه في كتابة النصوص داخل الصور ويستطيع أيضًا تعديل الصور. وتحصل الحسابات الجديدة في معظم المناطق على 16 رصيدًا مجانيًا، تكفي لصورتين.
كم يحتاج MOSS-Image من ذاكرة VRAM؟
لم تنشر OpenMOSS رقمًا لذلك. في اختبارات المجتمع بلغت ذروة الاستهلاك نحو 29 GiB لملفات الدقة الكاملة على RTX 5090، ونحو 16 GiB لملفات 8 بت على البطاقة نفسها، ونحو 11.6 GiB على RTX 4070 بذاكرة 12 GB. وتعمل نسخ 4 بت و GGUF على بطاقات 8 GB مع التفريغ إلى ذاكرة النظام، لكن بسرعة أقل.
MOSS-Image Base أم SFT: أيهما أنزّل؟
SFT لإنشاء الصور: فقد خضع لضبط دقيق ليجمّع النصوص وينظّم التخطيط بشكل أنظف. أما Base فهو النسخة الأصلية دون أي تعديل، وهي مخصّصة لتدريب LoRA وللبحث.
هل يستطيع MOSS-Image تعديل الصور؟
لا. يذكر التقرير التقني أنه لا يقبل صورًا مرجعية ولا يعدّل الصور، وتقول OpenMOSS إن التوليد المعتمد على صور مرجعية ما زال قيد الاستكشاف. وللتعديل، استخدم نموذجًا مثل Qwen Image 2.1 أو Nano Banana 2.1.
هل يدعم ComfyUI نموذج MOSS-Image؟
نعم، دعمًا أصليًا منذ ComfyUI 0.42.0 الصادر في 18 أكتوبر 2026. أما الإصدار 0.41.3 فلا يتضمنه. ويسرد دليل ComfyUI MOSS-Image الخاص بنا الملفات والمجلدات والإعدادات.
من طوّر MOSS-Image؟
OpenMOSS، الفريق في MOSI.AI الذي يقف وراء نماذج MOSS، بمشاركة باحثين من جامعة فودان وجامعة شنغهاي جياو تونغ ومعهد شنغهاي للابتكار. والتقرير التقني منشور برقم arXiv 2610.23374.
هل يرتبط Nano AI بـ OpenMOSS؟
لا. Nano AI خدمة مستقلة، تضع روابط إلى التنزيلات الرسمية من OpenMOSS ولا تستضيف MOSS-Image.
المزيد من Nano AI
صفحات ذات صلة
Nano AI خدمة مستقلة لا تتبع OpenMOSS أو MOSI.AI ولا تحظى باعتمادهما أو رعايتهما. معلومات MOSS-Image ودرجات اختباراته مصدرها بطاقات النموذج من OpenMOSS ومستودعها على GitHub وتقريرها التقني كما اطّلعنا عليها في 20 أكتوبر 2026؛ أما أرقام العتاد فهي قياسات من المجتمع. والصور النموذجية من بطاقة نموذج OpenMOSS، وتُستخدم بموجب ترخيص Apache 2.0.