
Actualizado el 20 de octubre de 2026 · ComfyUI 0.42.0+ · Sin nodos personalizados
Guía de ComfyUI MOSS-Image: instalar, descargar y ejecutar
ComfyUI MOSS-Image funciona de forma nativa desde ComfyUI 0.42.0. Esta guía detalla los archivos exactos, la carpeta en la que va cada uno, cuánta VRAM necesitan, los workflows oficiales y cómo resolver los errores más frecuentes.
¿Sin GPU, o sin tiempo para descargar 13 GB?
Prueba Qwen Image 2.1 online: texto en imagen parecido, sin instalar nada
Configurar ComfyUI MOSS-Image exige una descarga de 13 GB y una GPU de 12 GB o más. Qwen Image 2.1 es el modelo con el que más se compara MOSS-Image: ambos escriben texto en chino e inglés dentro de las imágenes, y en las pruebas lado a lado los resultados son parecidos. En Nano AI funciona en tu navegador por 8 créditos por imagen, y además puede editar fotos, algo que MOSS-Image no puede hacer.
- Desarrollado por
- OpenMOSS
- Lanzamiento
- 16 de octubre de 2026
- Disponible en Nano AI
- Qwen Image 2.1 · 8 créditos por imagen
- Página actualizada
- 20 de octubre de 2026
Fuente: github.com
Qué necesitas para ComfyUI MOSS-Image
MOSS-Image es el modelo abierto de texto a imagen de OpenMOSS: un transformer de difusión de 5B con el codificador de texto Qwen3.5-9B y el VAE de FLUX.2, publicado bajo Apache 2.0 el 16 de octubre de 2026. El soporte se integró en ComfyUI ese mismo día (pull request 17095) y llegó por primera vez a una versión estable con la 0.42.0, el 18 de octubre. La versión 0.41.3 y las anteriores no pueden cargarlo.
Con el soporte nativo no necesitas nodos personalizados. Los nodos estándar Load Diffusion Model, CLIP Loader y Load VAE leen los archivos reempaquetados de Comfy-Org/MOSS-Image, y ComfyUI añade un nodo MOSS-Image Layout Prompt para maquetaciones en JSON.
El plugin de MOSS-Image de OpenMOSS sigue disponible si quieres cargar la carpeta original de Hugging Face o conservar un workflow antiguo del plugin. Para una instalación nueva de ComfyUI MOSS-Image, sigue la vía nativa que se explica abajo.
Requisitos de ComfyUI MOSS-Image
- ComfyUI
- 0.42.0 o posterior, o una build nightly con el commit e087d8f6
- Nodos personalizados
- Ninguno con la vía nativa
- Descarga mínima
- Unos 13 GB: modelo de 8 bits, codificador de texto de 4 bits y VAE pequeño
- Descarga en precisión completa
- Unos 30 GB: modelo y codificador de texto en bf16
- Memoria de GPU
- 12 GB funcionaron con los archivos de 8 bits en pruebas de la comunidad; con 16 GB o más vas holgado
- Ajustes de la plantilla
- 25 pasos, CFG 2.5, er_sde, scheduler simple
- Ajustes de OpenMOSS
- 50 pasos, CFG 3, Euler, shift 5, skip layer 22
- Resolución
- De 1 a 2 megapíxeles, con lados múltiplos de 16
- Edición de imágenes
- El modelo no la admite
- Licencia
- Apache 2.0
Cómo instalar ComfyUI MOSS-Image
La vía nativa no necesita nodos personalizados. Los comandos suponen una instalación de ComfyUI con git; ComfyUI Desktop se actualiza solo, y la versión portable se actualiza con update/update_comfyui.bat.
- 1
Actualiza ComfyUI a 0.42.0 o posterior
El soporte de MOSS-Image se integró el 16 de octubre de 2026 y salió por primera vez en la 0.42.0, el 18 de octubre. Actualiza y vuelve a instalar los requisitos para que el nuevo código del codificador de texto quede instalado.
cd ComfyUI git pull pip install -r requirements.txt - 2
Descarga un archivo de cada tipo
Necesitas un modelo de difusión, un codificador de texto y un VAE de Comfy-Org/MOSS-Image. Estos tres son los que cargan las plantillas oficiales, unos 13 GB en total. La CLI de Hugging Face los coloca directamente en las carpetas correctas:
pip install -U huggingface_hub hf download Comfy-Org/MOSS-Image \ diffusion_models/moss_image_sft_int8_convrot.safetensors \ text_encoders/qwen3.5_9b_w4a8_gptq.safetensors \ vae/flux2-vae_small.safetensors \ --local-dir ComfyUI/models - 3
Comprueba las carpetas
Cada archivo va en su propia carpeta dentro de ComfyUI/models. Reinicia ComfyUI o pulsa R en la interfaz para actualizar las listas de modelos.
ComfyUI/models/diffusion_models/moss_image_sft_int8_convrot.safetensors ComfyUI/models/text_encoders/qwen3.5_9b_w4a8_gptq.safetensors ComfyUI/models/vae/flux2-vae_small.safetensors - 4
Abre una plantilla de ComfyUI MOSS-Image
Abre Templates, busca MOSS-Image y elige uno de los cuatro workflows oficiales: MOSS-Image Text to Image, MOSS-Image Base Text to Image o la versión Layout-Guided de cualquiera de los dos.
- 5
Revisa los nodos de carga y ejecuta
En Load Diffusion Model elige el archivo moss_image; en CLIP Loader, el archivo qwen3.5_9b con el tipo moss_image; y en Load VAE, flux2-vae_small. Escribe un prompt y haz clic en Run. Las plantillas usan 25 pasos, CFG 2.5 y er_sde; los ajustes de referencia de OpenMOSS son 50 pasos, CFG 3, Euler, shift 5 y skip layer 22.
- 6
Opcional: el plugin de OpenMOSS para la carpeta original
Para cargar en su lugar la carpeta completa de Hugging Face (unos 27 GB), instala el plugin de MOSS-Image desde ComfyUI Manager, o enlázalo con el script de abajo, y luego apunta el nodo MOSS-Image HF Loader a esa carpeta.
git clone https://github.com/OpenMOSS/MOSS-Image.git
cd MOSS-Image
python comfyui/install.py --comfy-root /path/to/ComfyUI
Archivos del modelo para ComfyUI MOSS-Image
Todos los archivos están en Comfy-Org/MOSS-Image, en Hugging Face (Apache 2.0). Elige un modelo de difusión, un codificador de texto y un VAE. Tamaños según la lista del 20 de octubre de 2026.
| Archivo | Carpeta en ComfyUI/models | Tamaño | Cuándo elegirlo |
|---|---|---|---|
| moss_image_sft_int8_convrot.safetensors | diffusion_models | 5.41 GB | El predeterminado de las plantillas oficiales: el modelo con ajuste fino en 8 bits |
| moss_image_sft_bf16.safetensors | diffusion_models | 10.2 GB | El modelo con ajuste fino en precisión completa, si tienes VRAM suficiente |
| moss_image_base_int8_convrot.safetensors | diffusion_models | 5.41 GB | El modelo Base en 8 bits, para LoRAs entrenados sobre Base |
| moss_image_base_bf16.safetensors | diffusion_models | 10.2 GB | El modelo Base en precisión completa, para entrenamiento e investigación |
| qwen3.5_9b_w4a8_gptq.safetensors | text_encoders | 7.34 GB | El codificador de texto más pequeño, el que usan las plantillas oficiales |
| qwen3.5_9b_int8_convrot.safetensors | text_encoders | 9.75 GB | El codificador de texto en 8 bits |
| qwen3.5_9b_bf16.safetensors | text_encoders | 19.3 GB | El codificador de texto en precisión completa |
| flux2-vae_small.safetensors | vae | 250 MB | El decodificador pequeño que incluyen el pipeline y las plantillas oficiales |
| flux2-vae.safetensors | vae | 336 MB | El VAE completo de FLUX.2 |
Lo que genera MOSS-Image
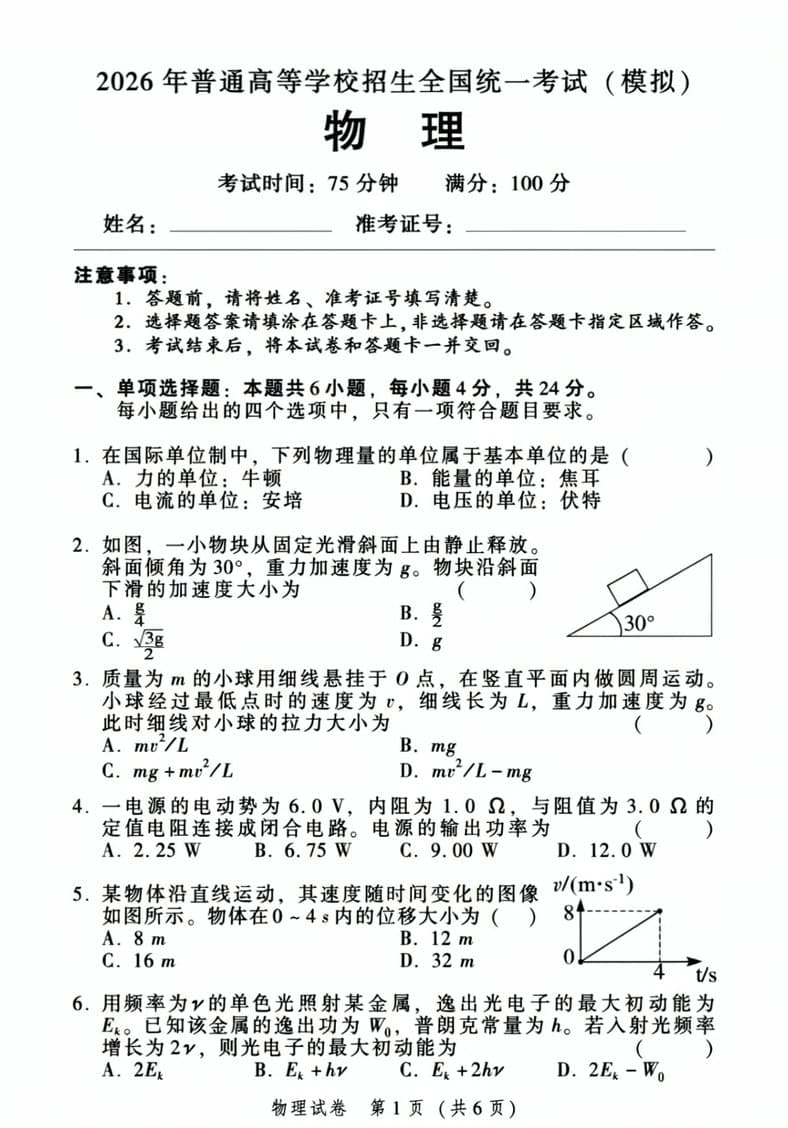
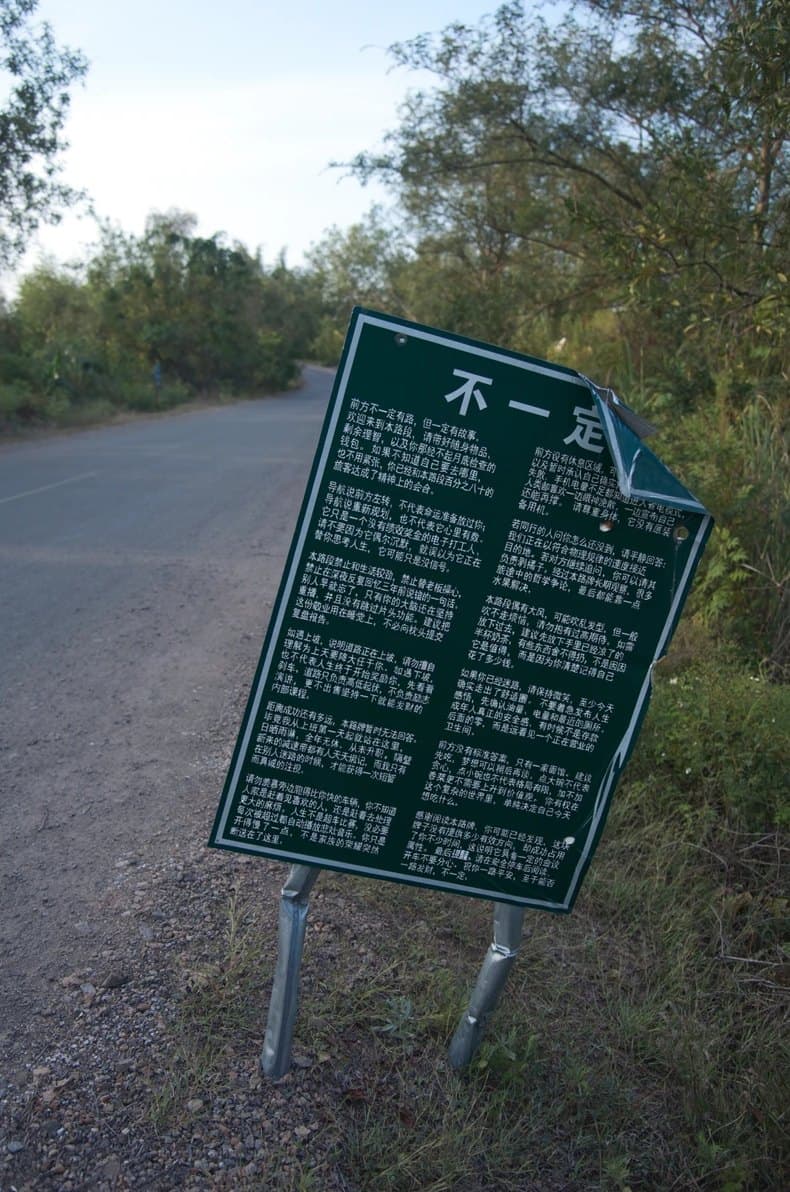
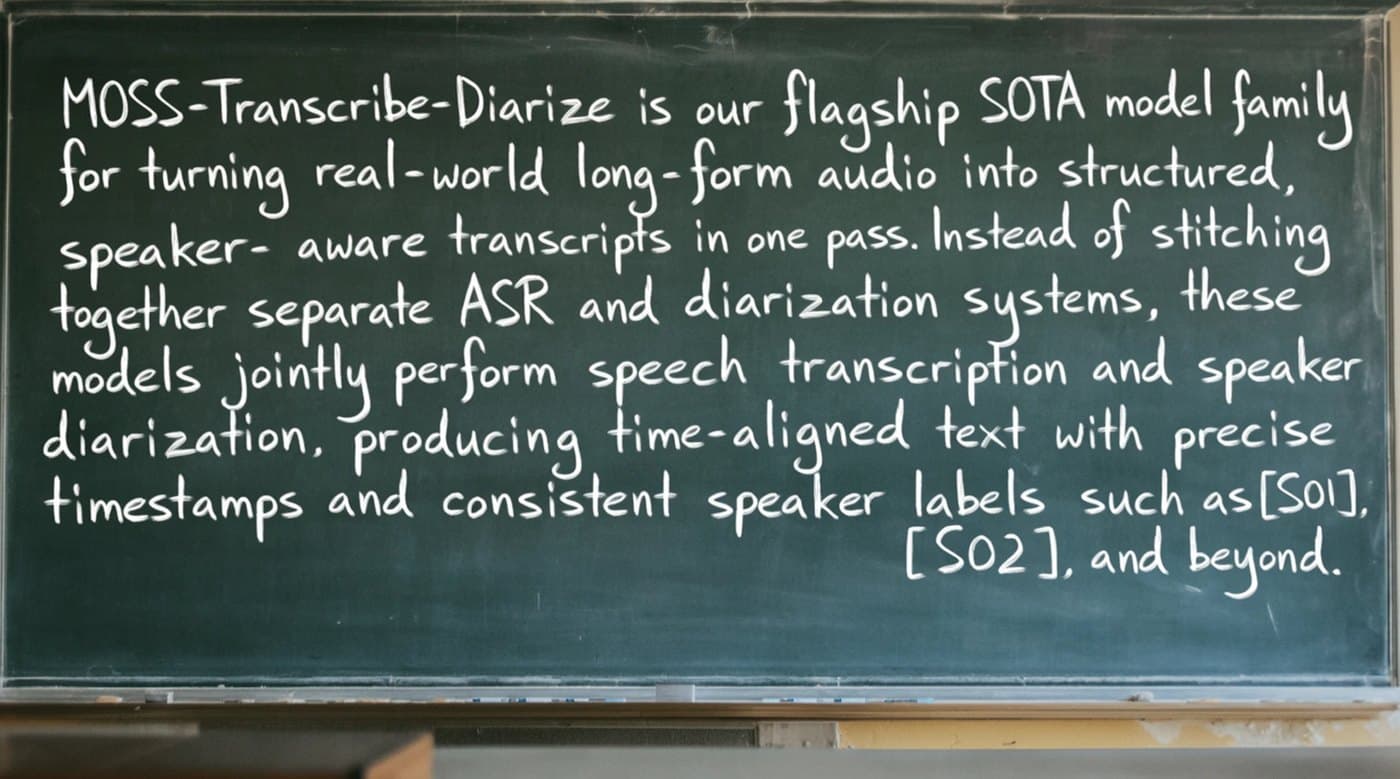
El texto denso en chino e inglés es donde más destaca MOSS-Image. Estas imágenes están recortadas de la galería de la ficha de modelo de OpenMOSS, sin retoques; los prompts no se publicaron, así que cada pie de foto describe la imagen.
Ajustes recomendados para ComfyUI MOSS-Image
Pasos: de 25 a 50
OpenMOSS recomienda 50 o más. Las plantillas de ComfyUI usan 25 con el sampler er_sde, lo que lleva más o menos la mitad de tiempo.
CFG: de 2.5 a 6
3 es el valor oficial por defecto y basta para prompts largos; súbelo para prompts cortos. Los LoRAs de 8 y 4 pasos usan CFG 1.
Shift: 5
Viene integrado en el modelo nativo. Si lo cambias, usa ModelSamplingAuraFlow con multiplicador 1, no ModelSamplingSD3.
Skip layer guidance: capa 22
Omitir la capa 22 en la pasada negativa mejora el detalle; las capas 24 y 26 también funcionan. Si lo desactivas, el resultado parece más fotográfico, pero los detalles pueden desmoronarse.
Resolución: de 1 a 2 megapíxeles
De 1024 × 1024 hasta unos 1456 × 1456, en cualquier relación de aspecto con lados múltiplos de 16. El modelo admite desde 512 × 512 hasta 2K.
Prompt negativo: etiquetas cortas
Déjalo vacío o usa las etiquetas de calidad de la guía de uso de OpenMOSS: worst quality, bad anatomy, watermark, jpeg artifact.
Velocidad y VRAM de ComfyUI MOSS-Image en pruebas de la comunidad
OpenMOSS no ha publicado cifras de VRAM. Estas son mediciones que la gente compartió en YouTube, note.com, X y Hugging Face la semana posterior al lanzamiento; el pico de memoria corresponde a toda la GPU.
| Archivos del modelo | Tamaño y pasos | Tiempo por imagen | Pico de VRAM | |
|---|---|---|---|---|
| RTX 5090, precisión completa | SFT bf16 | 1024 × 1024, 50 pasos | 27.4 s | 29.2 GiB |
| RTX 5090, 8 bits | SFT int8 | 1024 × 1024, 50 pasos | 10.5 s | 16.4 GiB |
| RTX 5090, pasos de la plantilla | int8 | 1 megapíxel, 25 pasos | 5.7 s | Sin datos |
| RTX 4070 12 GB | Base int8, codificador de texto int8 | 832 × 1216, 50 pasos | 50 a 52 s | 11.6 GiB |
| RTX 3060 Ti 8 GB | int8 | 720p, 50 pasos | 52 s | Sin datos |
| DGX Spark | Sin datos | 1024 × 1024, 25 y 50 pasos | 30 s y 48 s | Sin datos |
Workflows, herramientas y tutoriales de ComfyUI MOSS-Image
Primero las fuentes oficiales y después los proyectos de la comunidad, todo comprobado el 20 de octubre de 2026.
Cómo escribir prompts para ComfyUI MOSS-Image
- 1
Describe la escena en inglés
El inglés es el idioma con más datos de entrenamiento. Describe el sujeto, el entorno, la iluminación y el estilo; un prompt puede llegar a 4,096 tokens.
- 2
Pon entre comillas el texto que quieres
Escribe las palabras exactas entre comillas y añade saltos de línea donde deban cortarse las líneas. Funcionan tanto el chino como el inglés.
- 3
Coloca los elementos con una maquetación
Para pósters y páginas, usa la plantilla Layout-Guided o una maquetación en JSON: una descripción general más una lista de elementos con recuadros en píxeles, medidos desde el centro del lienzo.
Prompts de ComfyUI MOSS-Image para empezar
Pégalos en el prompt positivo, o en el negativo cuando se indique. El ejemplo de maquetación es para un lienzo de 1024 × 1024.
Maquetación en JSON (ejemplo oficial)
{"summary": {"meta": ["poster"], "canvas": "single", "caption": "A minimalist travel poster with a cream background, a blue mountain illustration, and the title EXPLORE at the top."}, "items": [{"label": "text", "caption": "Large dark-blue uppercase title centered at the top.", "text": "EXPLORE", "bbox": [-416, -384, -288, 384]}, {"label": "object", "caption": "A flat blue mountain illustration in the lower center.", "bbox": [-192, -288, 384, 288]}], "bbox_coord_space": "abs_centralized", "bbox_format": "yxyx"}
Página impresa con fórmulas
A printed physics exam page in Chinese titled "物理" with numbered multiple-choice questions, a small diagram of a block on a 30° slope and the footer "物理试卷 第1页(共6页)", flat scan, black ink on white paper
Orden de las etiquetas
best quality, highres, scenery, night city, river, skyline reflections, long exposure, no humans
Prompt negativo (etiquetas de calidad)
worst quality, bad anatomy, watermark, jpeg artifact
Errores de ComfyUI MOSS-Image y cómo solucionarlos
Los problemas más mencionados en los primeros días tras el lanzamiento y lo que los resolvió.
- CLIP Loader no tiene el tipo moss_image
- Tu ComfyUI es anterior a la 0.42.0; la 0.41.3 no incluye MOSS-Image. Actualiza, vuelve a ejecutar pip install -r requirements.txt y reinicia.
- Resultados extraños tras dejar el plugin
- Los workflows del plugin usan ModelSamplingSD3, que tiene otra escala de timesteps. Abre una plantilla nativa en lugar de cambiar los loaders, y ajusta el shift con ModelSamplingAuraFlow con multiplicador 1.
- Imágenes grises y desvaídas
- Quita --use-sage-attention de las opciones de arranque. Usuarios de la página del modelo de Comfy-Org señalan que desatura las imágenes de MOSS-Image.
- Memoria insuficiente
- Usa el modelo de 8 bits, el codificador de texto de 4 bits y flux2-vae_small, quédate en torno a 1 megapíxel y deja que ComfyUI haga offloading, o arráncalo con --lowvram.
- Franjas verticales en las imágenes de SFT
- Un problema conocido de SFT. Prueba el LoRA DeBand de la comunidad, la corrección con peso negativo de Kijai o el modelo Base.
- Imágenes negras
- Suele deberse a un desbordamiento de fp16 en resoluciones altas. Ejecuta en bf16 o usa los pesos FP16-fixed de KBlueLeaf.
- Generación muy lenta
- 50 pasos con skip layer guidance suponen dos pasadas por paso. Usa los 25 pasos de la plantilla, un LoRA de 8 o 4 pasos con CFG 1, o los nodos Spectrum.
- Palabras incorrectas o que faltan
- Pon el texto exacto entre comillas, añade saltos de línea donde deban cortarse las líneas, escribe el resto del prompt en inglés y, con prompts cortos, sube el CFG a un valor de entre 4 y 6.
- La imagen de referencia no hace nada
- MOSS-Image no puede usar imágenes de referencia. En las plantillas, ref_image solo alimenta el mejorador de prompts opcional.
- Misma semilla, imagen distinta que en Python
- Es lo esperado. El scheduler de ComfyUI no se ajusta a la cuadrícula de entrenamiento que usa el pipeline de Python, así que los resultados difieren.
¿Sin GPU, o sin tiempo para descargar 13 GB?
Prueba Qwen Image 2.1 online: texto en imagen parecido, sin instalar nada
Configurar ComfyUI MOSS-Image exige una descarga de 13 GB y una GPU de 12 GB o más. Qwen Image 2.1 es el modelo con el que más se compara MOSS-Image: ambos escriben texto en chino e inglés dentro de las imágenes, y en las pruebas lado a lado los resultados son parecidos. En Nano AI funciona en tu navegador por 8 créditos por imagen, y además puede editar fotos, algo que MOSS-Image no puede hacer.
Preguntas frecuentes
Preguntas frecuentes sobre ComfyUI MOSS-Image
Respuestas breves a lo que más se pregunta sobre cómo ejecutar MOSS-Image en ComfyUI.
¿Qué versión de ComfyUI es compatible con MOSS-Image?
La 0.42.0, publicada el 18 de octubre de 2026, o una build nightly del 16 de octubre en adelante (commit e087d8f6). La 0.41.3 no lo es, aunque algunas guías digan lo contrario.
¿Necesito un nodo personalizado para MOSS-Image en ComfyUI?
No. Desde la 0.42.0, los loaders estándar leen los archivos de Comfy-Org/MOSS-Image. El plugin de OpenMOSS solo hace falta para cargar la carpeta original de Hugging Face.
¿Cuánta VRAM necesita ComfyUI MOSS-Image?
No hay una cifra oficial. Con el modelo de 8 bits y el codificador de texto de 4 bits, una tarjeta de 12 GB funcionó en pruebas de la comunidad, y las tarjetas de 8 GB ejecutan configuraciones de 4 bits o GGUF con offloading, aunque despacio. En precisión completa, el pico fue de unos 29 GiB en una RTX 5090.
¿Hay una versión GGUF o fp8 de MOSS-Image?
No de OpenMOSS ni de Comfy-Org, que en su lugar publican archivos de 8 bits (int8) y 4 bits (w4a8). Existen archivos GGUF de la comunidad, pero necesitan nodos personalizados adicionales, y Comfy-Org ha dicho que GGUF no tendrá soporte nativo.
¿Dónde van los archivos de ComfyUI MOSS-Image?
Dentro de ComfyUI/models: los archivos moss_image en diffusion_models, los qwen3.5_9b en text_encoders y los flux2-vae en vae.
¿Base o SFT para ComfyUI MOSS-Image?
SFT para las imágenes del día a día. Base para entrenar LoRAs, o cuando un LoRA se entrenó sobre Base.
¿ComfyUI MOSS-Image puede editar imágenes o usar una imagen de referencia?
No, solo hace texto a imagen. Para editar, Qwen Image 2.1 y Nano Banana 2.1 en Nano AI admiten hasta 5 imágenes de referencia.
¿Puedo obtener resultados parecidos sin instalar nada?
Sí. Prueba la demo de OpenMOSS en Hugging Face, o Qwen Image 2.1 en Nano AI, el modelo con el que más se compara MOSS-Image para texto dentro de las imágenes. En la mayoría de las regiones, las cuentas nuevas reciben 16 créditos gratis, suficientes para 2 imágenes de Qwen Image 2.1.
Más en Nano AI
Páginas relacionadas
Nano AI es un servicio independiente y no está afiliado a OpenMOSS, MOSI.AI ni Comfy Org. Los nombres, tamaños y versiones de los archivos proceden de Hugging Face, GitHub y las notas de versión de ComfyUI, consultados el 20 de octubre de 2026; las cifras de velocidad y VRAM son mediciones de la comunidad. Las imágenes de ejemplo proceden de la ficha de modelo de OpenMOSS y se usan bajo la licencia Apache 2.0.