
Guía de un tercero · Pruna · 3 de noviembre de 2026
P-H3-Image: qué pack descargar para una GPU más pequeña
Esta es una presentación de un tercero, no el sitio de Pruna ni una página de MiniMax. P-H3-Image es el modelo de imagen abierto de Pruna, construido sobre MiniMax-H3. Nano AI no aloja los pesos y no puede ejecutar P-H3-Image.
¿Sin GPU local?
Qwen Image 2.1 corre en el navegador, en lugar de P-H3-Image
Nano AI no ejecuta P-H3-Image. Qwen Image 2.1 es otro modelo que este sitio cobra: 8 créditos por imagen a 1K, hasta 5 imágenes de referencia. Los 64 créditos de alta cubren 8 de esas imágenes. No es un render de P-H3-Image.
- Desarrollado por
- Pruna
- Lanzamiento
- 3 de noviembre de 2026
- Disponible en Nano AI
- Qwen Image 2.1 · 8 créditos por imagen
- Página actualizada
- 5 de noviembre de 2026
Fuente: pruna.ai
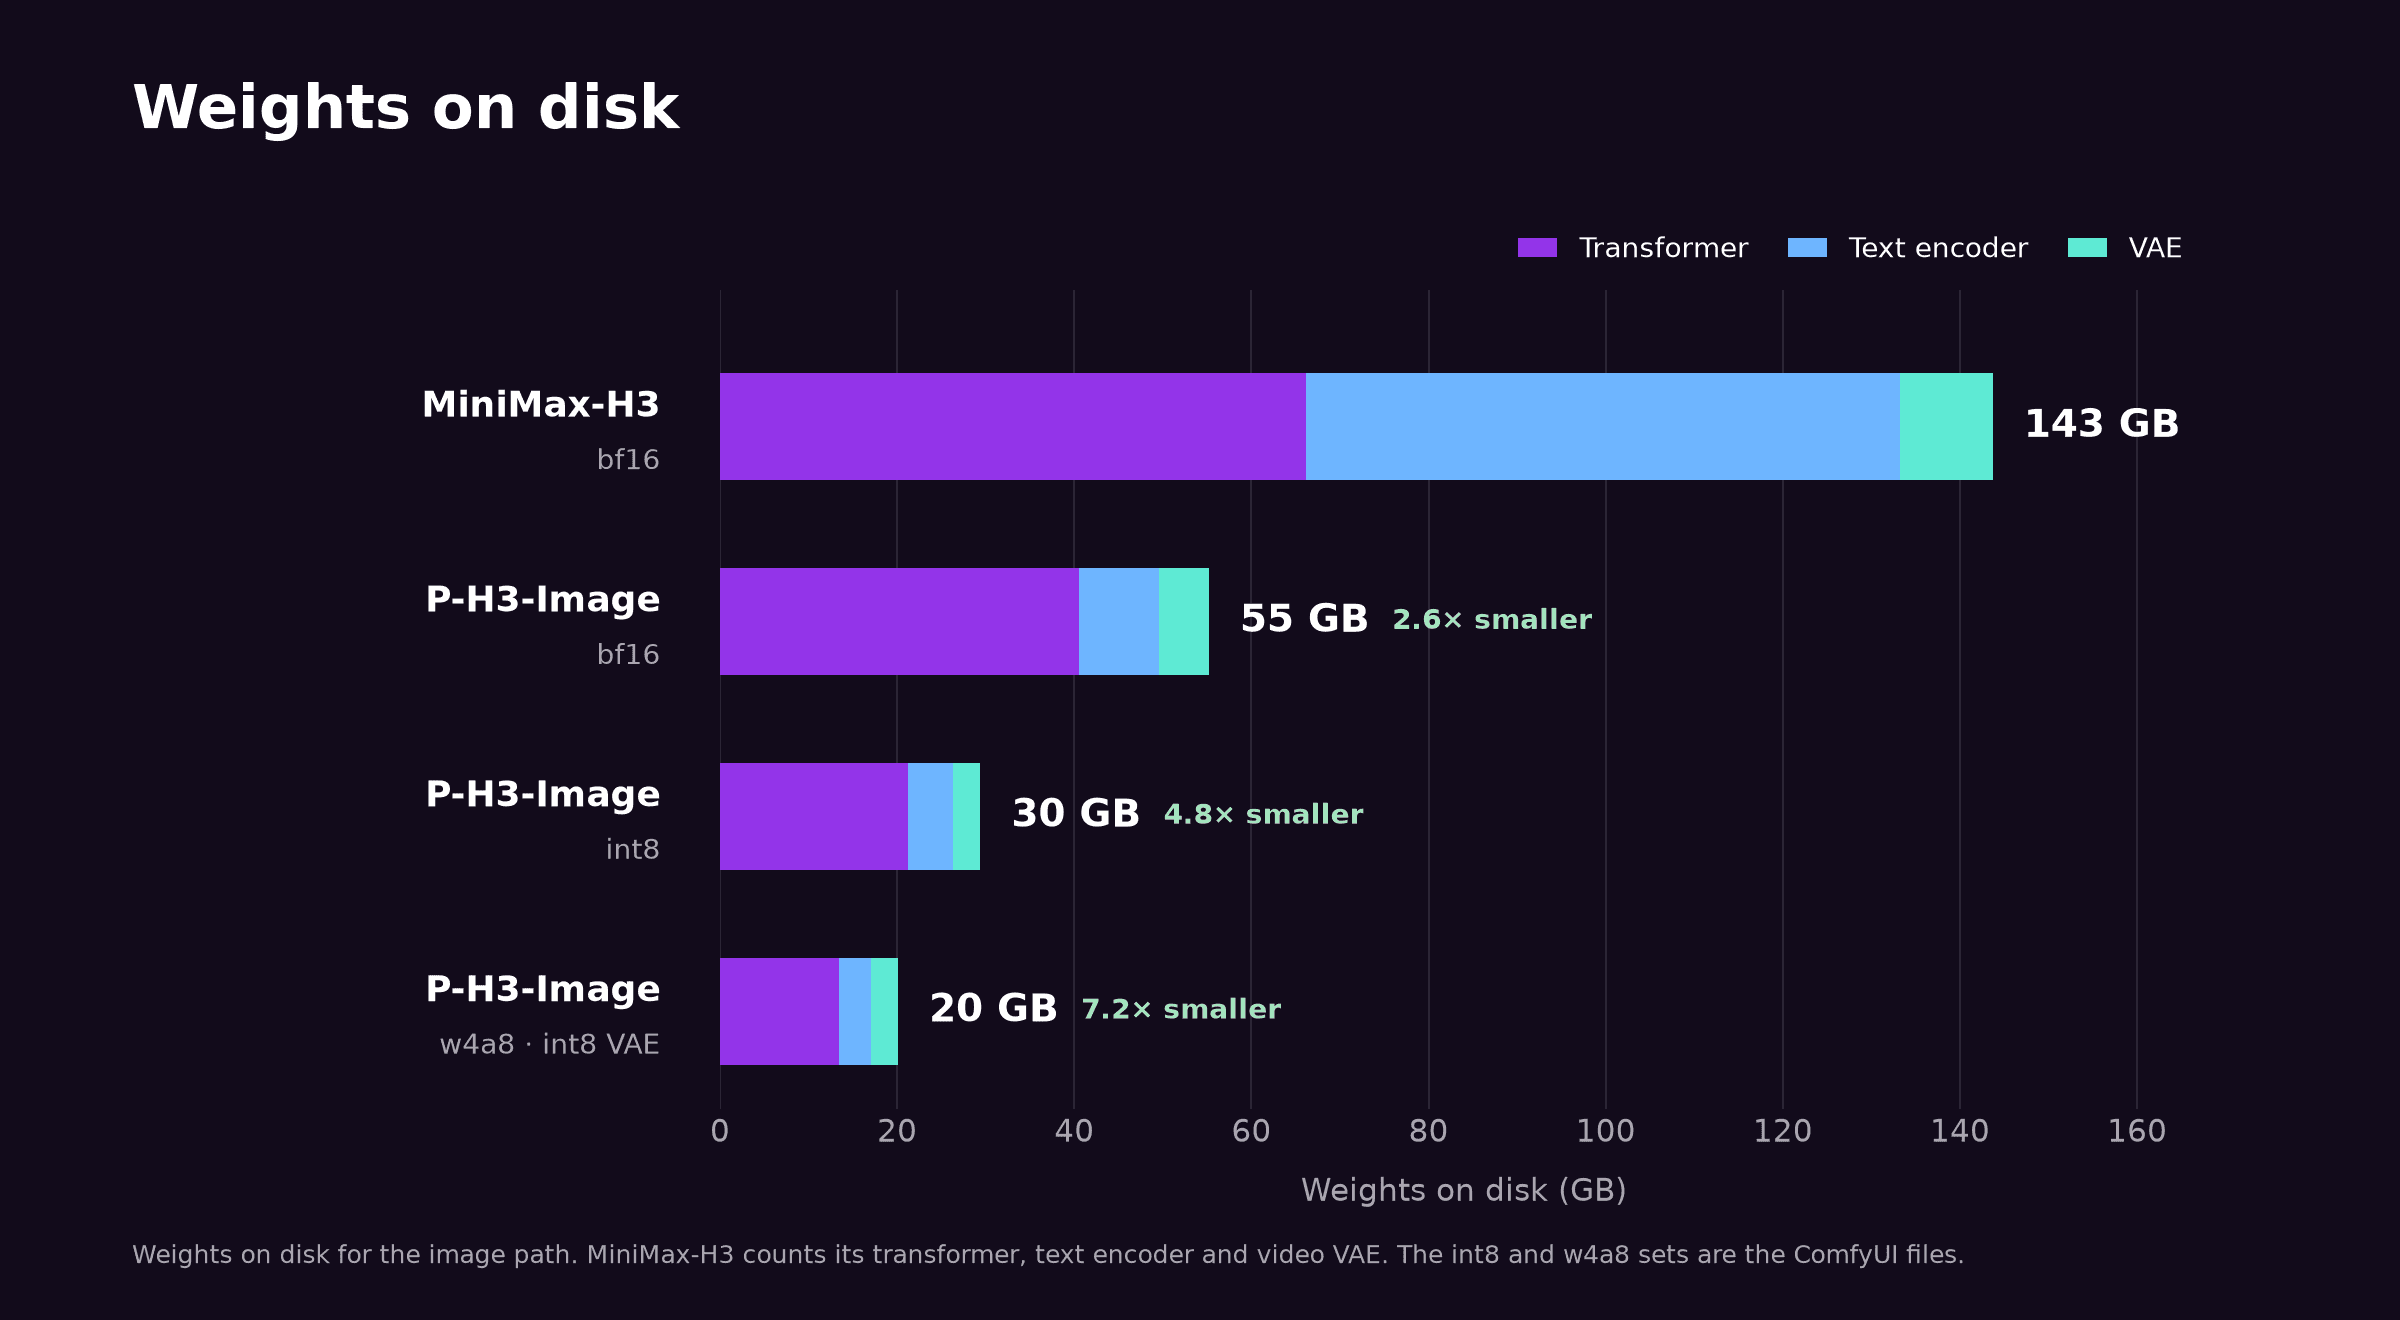
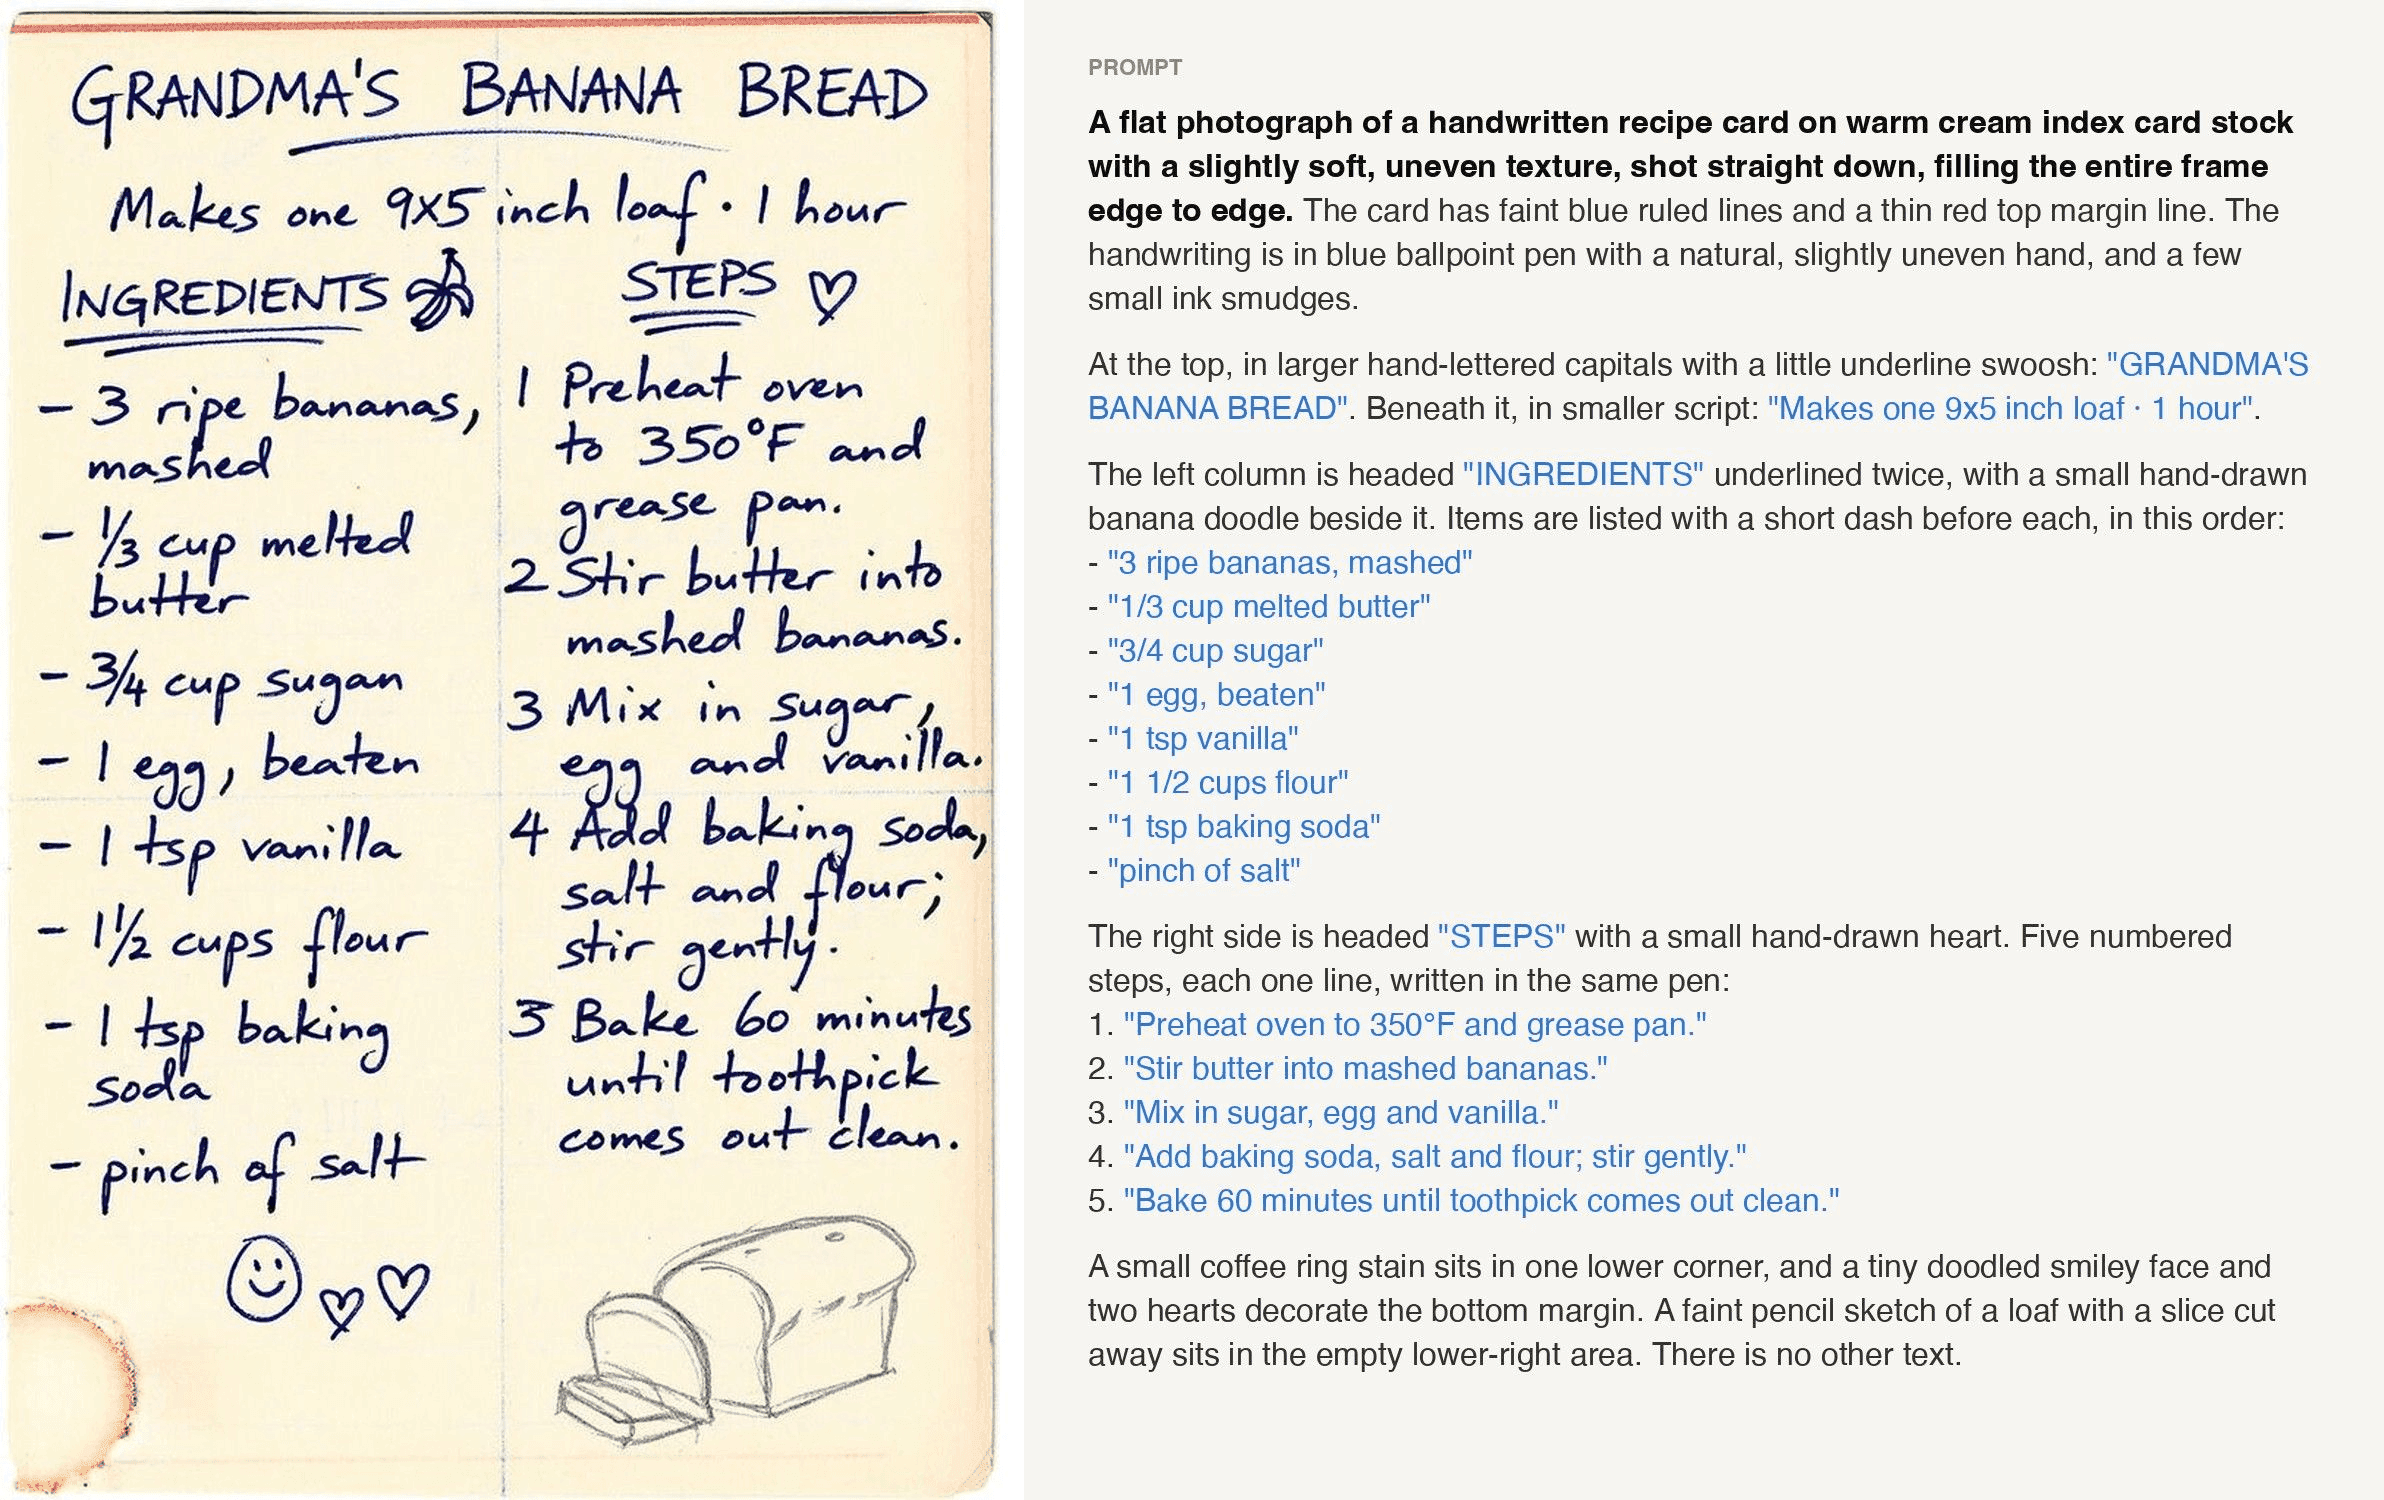
Figuras de la nota de Pruna
Descargadas el 2026-11-05 del blog del 3 de noviembre de 2026. El gráfico es su comparación de tamaño. La ficha de receta es su ejemplo de letra manuscrita, y los números de paso no coinciden con el prompt de al lado. Ninguno de los dos archivos es una imagen de Nano AI.
Qué es P-H3-Image
El blog de Pruna, con fecha del 3 de noviembre de 2026, presenta P-H3-Image como un modelo abierto de texto a imagen y de edición, hecho al rehacer MiniMax-H3. La apertura dice que la versión más pequeña es unas 7 veces menor que H3, 20 GB en vez de 143 GB, y unas 5 veces más rápida, 2.6 segundos en vez de 12.4 segundos para una imagen de 4 MP en una B200. Su gráfico en el mismo texto etiqueta el conjunto ComfyUI de 20 GB como 7.2× más pequeño que 143 GB. Son cifras de Pruna. Este sitio no ha cronometrado una GPU.
La ficha de ComfyUI, leída el mismo día que esta página, separa tres conjuntos: bf16 con descarga de 55 GB y unos 56 GB de VRAM pico a 8 MP, int8 con 30 GB y unos 31 GB, y w4a8 con un VAE int8 de 20 GB y unos 21 GB. Esos totales son el modelo de difusión, el codificador de texto y el VAE. El ampliador de prompt va aparte: el archivo bf16 recomendado son 19.3 GB y unos 21 GB de pico. Una tarjeta de 24 GB no es una cifra que la ficha prometa. Dice que uses un ampliador más pequeño cuando 21 GB no caben.
Los pesos siguen la MiniMax H3 Community License. La ficha y el blog dicen que esa licencia excluye a la Unión Europea, el Reino Unido, la República de Corea y Estados Unidos, salvo que tengas una licencia aparte de MiniMax, y que los productos hechos sobre ella deben mostrar "Powered by MiniMax H3". Las partes Qwen del codificador de texto y del ampliador están bajo Apache-2.0. El blog dice que los nodos de ComfyUI son MIT. Lee la licencia. Esta página no decide si tu uso está permitido.
Packs de P-H3-Image según la ficha de ComfyUI
- Quién lo publicó
- Pruna, 3 de noviembre de 2026, basado en MiniMax-H3
- Esta página
- Una guía de un tercero. Nano AI no ejecuta los pesos
- Conjunto bf16
- Descarga de 55 GB, unos 56 GB de VRAM pico a 8 MP
- Conjunto int8
- Descarga de 30 GB, unos 31 GB de VRAM pico a 8 MP
- Conjunto w4a8
- Descarga de 20 GB, unos 21 GB de VRAM pico a 8 MP
- Ampliador
- Aparte. Archivo recomendado de 19.3 GB, unos 21 GB de pico
- Pasos
- 8, sin CFG, sin prompt negativo, según la ficha
- Entradas de edición
- Ficha: hasta 8 imágenes. Apertura del blog: hasta 9. Sigue la ficha en ComfyUI
Ocho pasos de ComfyUI para P-H3-Image
Copiados de la ficha PrunaAI/P-H3-Image-Comfy y del blog del 3 de noviembre de 2026, leídos el 5 de noviembre de 2026. Este sitio no ha instalado los archivos.
- 1
Actualiza ComfyUI desde GitHub
La ficha dice que el soporte está en master y que llega con la próxima versión. Hasta entonces, actualiza una instalación git a la última nightly. La app de escritorio y Comfy Cloud siguen las versiones estables.
cd ComfyUI && git pull - 2
Elige un pack antes de descargar
La tabla de conjuntos de la ficha, modelo más codificador de texto más VAE, sin contar el ampliador de prompt: bf16 es una descarga de 55 GB y unos 56 GB de VRAM pico a 8 MP; int8 son 30 GB y unos 31 GB; w4a8 con el VAE int8 son 20 GB y unos 21 GB. La ficha dice que int8 se queda muy cerca de bf16, y que w4a8 cambia más detalles y a veces la composición.
- 3
Descarga un archivo por componente
Pon los archivos bajo ComfyUI/models. El comando de abajo es el conjunto más pequeño de la ficha. El ampliador de ese comando es el archivo bf16 de 19.3 GB, que va aparte. La ficha también imprime el nombre del repositorio una vez en minúsculas; si una descarga falla, prueba PrunaAI/P-H3-Image-Comfy.
hf download PrunaAI/P-H3-Image-Comfy --include "diffusion_models/p-h3-image_w4a8.safetensors" "text_encoders/p-h3-image_text_encoder_w4a8.safetensors" "text_encoders/p-h3-image_prompt_upsampler_bf16.safetensors" "vae/p-h3-image_vae_int8_convrot.safetensors" --local-dir ComfyUI/models - 4
Abre un flujo desde workflows/
La ficha lista p-h3-image_text_to_image.json, p-h3-image_edit.json y dos flujos lora para quien ya tiene MiniMax-H3. Los flujos usan los nodos propios de ComfyUI.
- 5
Revisa los cargadores
Load Diffusion Model toma el archivo de difusión. ModelSamplingMiniMaxH3 queda en 1.0 para los dos shifts. Load CLIP usa el tipo minimax. Load VAE toma el VAE. p-h3-image Conditioning convierte el prompt y las imágenes en el acondicionamiento y el latente.
- 6
Deja el ampliador encendido, salvo si la VRAM es el límite
La ficha dice que las peticiones cortas salen débiles sin él. El ampliador recomendado es p-h3-image_prompt_upsampler_bf16, 19.3 GB, unos 21 GB de pico y unos 7 segundos por prompt en una L40S. Los más pequeños son de 9.7 GB y 6.7 GB. Úsalos solo cuando 21 GB no caben. ComfyUI saca el ampliador de la VRAM cuando el modelo de imagen necesita la memoria.
- 7
Ejecuta el muestreador de 8 pasos
Los flujos muestrean con ManualSigmas, la rejilla de 8 pasos, Basic Guider, euler y Sampler Custom Advanced. La ficha dice que no hay CFG ni prompt negativo. El texto a imagen prefiere 8 MP. El tamaño 1:1 de la ficha a 8 MP es 2912 por 2912.
- 8
En una edición, conserva el orden de las imágenes
Conecta la imagen a editar como image_1 y hasta 7 referencias después, en el mismo orden en Batch Images y en p-h3-image Conditioning. La ficha dice que las ediciones funcionan mejor a 4 u 8 MP. La frase inicial del blog dice hasta 9 imágenes de entrada; la ficha y el texto posterior del blog dicen 8. Sigue la ficha en ComfyUI.
Archivos de P-H3-Image para una GPU más pequeña
Los tamaños son los de la tabla de la ficha ComfyUI, leída el 5 de noviembre de 2026. El conjunto de 20 GB es el modelo de difusión, el codificador de texto y el VAE int8. El ampliador va aparte.
| Archivo | Carpeta en ComfyUI/models | Tamaño en la ficha | Cuándo lo señala la ficha |
|---|---|---|---|
| p-h3-image_w4a8.safetensors | diffusion_models | 13.4 GB | El archivo de difusión más pequeño. La ficha dice que cambia más detalles que bf16. |
| p-h3-image_text_encoder_w4a8.safetensors | text_encoders | 3.6 GB | Codificador de texto emparejado con el conjunto más pequeño. |
| p-h3-image_vae_int8_convrot.safetensors | vae | 3.1 GB | VAE del conjunto de 20 GB. La ficha no lista un VAE w4a8. |
| p-h3-image_bf16.safetensors | diffusion_models | 40.5 GB | Archivo de difusión en precisión completa. El conjunto bf16 son 55 GB y unos 56 GB de pico a 8 MP. |
| p-h3-image_prompt_upsampler_bf16.safetensors | text_encoders | 19.3 GB | Ampliador recomendado. Unos 21 GB de pico. No entra en los totales de 20 GB ni de 55 GB. |
Qué pack está describiendo la ficha
20 GB es el conjunto w4a8
Difusión 13.4 GB, codificador de texto 3.6 GB, VAE int8 3.1 GB. El pico a 8 MP es de unos 21 GB. La ficha dice que este conjunto cambia más detalles, y a veces la composición, que bf16.
30 GB se queda más cerca
El conjunto int8 son 30 GB y unos 31 GB de pico. La ficha dice que se queda muy cerca de bf16, a menudo casi píxel a píxel. Es su comparación, no una prueba hecha aquí.
55 GB sigue sin ser el ampliador
El modelo bf16, el codificador y el VAE suman el conjunto de 55 GB y unos 56 GB de pico. El ampliador de 19.3 GB va encima, salvo que lo apagues.
Si ya tienes MiniMax-H3
La ficha ofrece un LoRA de 2.0 GB, loras/p-h3-image_lora_bf16.safetensors, sobre tu transformer FL2VA existente, en vez de una segunda descarga completa. Esta página no ha cargado ese LoRA.
P-H3-Image, MOSS-Image, FLUX.3 Klein y Qwen Image 2.1
Las celdas de P-H3-Image salen de la ficha y el blog de Pruna leídos el 5 de noviembre de 2026. Las de MOSS-Image siguen la página MOSS-Image de este sitio. Las dos últimas columnas son modelos que Nano AI cobra. Aquí nadie cronometró los cuatro entre sí.
| P-H3-Image | MOSS-Image | FLUX.3 Klein aquí | Qwen Image 2.1 aquí | |
|---|---|---|---|---|
| Quién lo publica | Pruna, sobre MiniMax-H3 | OpenMOSS | Black Forest Labs | Alibaba |
| Licencia que imprimen | MiniMax H3 Community License, con regiones excluidas | Apache 2.0 | FLUX Kommunity License | Qwen Research License en la página de pesos |
| Dónde corre | Tu GPU, ComfyUI | Tu GPU, ComfyUI | Este sitio, 4 créditos | Este sitio, 8 créditos |
| Edición | Ficha: hasta 8 imágenes de entrada | No, en la página MOSS-Image | Sí, hasta 5 referencias aquí | Sí, hasta 5 referencias aquí |
| Un tamaño que publican | Conjunto ComfyUI más pequeño: 20 GB | Archivos locales, ver la página ComfyUI MOSS | 1K en este sitio | 1K en este sitio |
| El botón de este sitio | No ejecuta P-H3-Image | No ejecuta los pesos MOSS | FLUX.3 Klein | Qwen Image 2.1, la opción sin instalar |
Fuentes primarias
Léelas antes de descargar. Esta página no es un espejo.
Si no vas a instalarlo
- 1
Lee primero la licencia
La ficha dice que la Unión Europea, el Reino Unido, la República de Corea y Estados Unidos quedan fuera de la licencia, salvo que MiniMax conceda una aparte. Usa el texto de la licencia, no esta frase, para decidir.
- 2
O abre un modelo que este sitio ejecuta
Qwen Image 2.1 cuesta 8 créditos a 1K. Es otro modelo. El botón no carga los pesos de P-H3-Image.
- 3
Compara con las páginas que ya tienes
MOSS-Image y su guía de ComfyUI cubren otro modelo de texto local. FLUX.3 Klein es el modelo de 4 créditos en este sitio. Ninguna de esas páginas ejecuta P-H3-Image.
Indicaciones para Qwen Image 2.1, no para los pesos locales
Úsalas solo en el modelo del navegador. No configuran ComfyUI y no son indicaciones de P-H3-Image.
Rótulo de librería
A small bookstore window at dusk, a paper sign that reads "Late hours" and nothing else, warm light, no people.
Ficha de receta
A flat photograph of an index card titled "Oat loaf". Three ingredient lines and three steps, blue ink, no people, no extra text.
Muro de musgo
A damp stone wall covered in moss, one fern, soft overcast light, no text, no people.
Cambiar el rótulo
Change the sign text to "Open". Keep the window, the light and the frame exactly as they are.
Límites que la ficha ya imprime
- El conjunto más pequeño igual cambia la imagen
- La ficha dice que w4a8 conserva la calidad pero cambia más detalles y a veces la composición. int8 se queda más cerca de bf16. Si quieres el acercamiento de la ficha, el conjunto int8 son 30 GB y unos 31 GB de pico, no el de 20 GB.
- Los prompts cortos salen débiles
- La ficha dice que el modelo es sensible al prompt y que los prompts muy cortos quedan débiles sin el ampliador. Las palabras de énfasis y los prompts muy largos empeoran las imágenes.
- Texto y manos
- La ficha dice que las manos pueden romperse, que las figuras pequeñas del fondo pueden deformarse y que el texto pequeño o denso se vuelve poco fiable. Las cadenas cortas entre comillas salen mejor. La muestra de la receta en esta página muestra un desajuste de numeración que se puede ver.
- Mayúsculas del nombre del repositorio
- Un comando de la ficha usa PrunaAI/P-H3-Image-comfy y el siguiente usa PrunaAI/P-H3-Image-Comfy. Si una descarga devuelve 404, prueba la otra forma. La URL de la ficha usa la C mayúscula.
¿Sin GPU local?
Qwen Image 2.1 corre en el navegador, en lugar de P-H3-Image
Nano AI no ejecuta P-H3-Image. Qwen Image 2.1 es otro modelo que este sitio cobra: 8 créditos por imagen a 1K, hasta 5 imágenes de referencia. Los 64 créditos de alta cubren 8 de esas imágenes. No es un render de P-H3-Image.
Preguntas frecuentes
Preguntas sobre P-H3-Image
Las cifras salen del blog de Pruna y de la ficha de ComfyUI, leídos el 5 de noviembre de 2026. Este sitio no las volvió a medir.
¿Nano AI ejecuta P-H3-Image?
No. No hay un control de P-H3-Image en este sitio. El modelo del navegador en el recuadro de arriba es Qwen Image 2.1, a 8 créditos por imagen. Es otro modelo.
¿Cuál es el pack pequeño?
El conjunto w4a8 de la ficha: una descarga de 20 GB y unos 21 GB de VRAM pico a 8 MP, con el VAE int8. El ampliador no está dentro de esos 20 GB. La ficha dice que este conjunto puede cambiar detalles y a veces la composición.
¿Y si 21 GB no caben?
La ficha dice que uses un ampliador más pequeño, de 9.7 GB o 6.7 GB, solo cuando el de 21 GB no cabe. No promete una tarjeta gráfica de consumo concreta. Los conjuntos de imagen int8 y bf16 son más grandes, no más pequeños.
¿La licencia permite el uso comercial en todas partes?
No lo saques de esta página. La ficha dice que la licencia excluye a la Unión Europea, el Reino Unido, la República de Corea y Estados Unidos, salvo que MiniMax conceda una licencia aparte, y que los productos deben mostrar "Powered by MiniMax H3". Lee la licencia.
¿Cómo se compara con MOSS-Image y con FLUX?
MOSS-Image es otro modelo abierto que ejecutas tú; su página dice que no edita. FLUX.3 Klein en este sitio cuesta 4 créditos a 1K y sí edita. P-H3-Image es el modelo ComfyUI de Pruna. Este sitio no hizo una prueba lado a lado.
¿Verificaste un kit de ajuste fino?
No. Una mención pública de soporte de herramientas no se abrió para esta página, así que no se listan pasos de ajuste, nombres de archivo ni ajustes.
Más en Nano AI
Modelos locales y alojados relacionados
Nano AI es un servicio independiente y no está afiliado a Pruna ni a MiniMax. Las cifras de P-H3-Image salen del blog del 3 de noviembre de 2026 y de la ficha PrunaAI/P-H3-Image-Comfy leída el 5 de noviembre de 2026. Manda el texto de la licencia. Este sitio no ejecuta los pesos. La alternativa en el navegador es Qwen Image 2.1 a 8 créditos.