
OpenMOSS · Lanzado el 16 de octubre de 2026 · Apache 2.0
MOSS-Image: el modelo abierto para texto y maquetación en imágenes
MOSS-Image es un modelo de texto a imagen de 5B con pesos abiertos, creado por OpenMOSS, que escribe textos largos en chino e inglés dentro de las imágenes y sigue maquetaciones definidas en JSON. A continuación: especificaciones, puntuaciones en benchmarks, imágenes de ejemplo y cómo ejecutarlo.
MOSS-Image se ejecuta en tu propia GPU, así que Nano AI no lo aloja. El modelo con el que más se le compara es Qwen Image 2.1, igual de centrado en el texto en chino e inglés dentro de las imágenes. Es el que usa este generador: 8 créditos por imagen, sin necesidad de GPU.
16 créditos gratis = 2 imágenes estándar. Sin tarjeta.
Panel de resultados
Las variaciones que generes aparecerán aquí.
- Desarrollado por
- OpenMOSS
- Lanzamiento
- 16 de octubre de 2026
- Disponible en Nano AI
- Qwen Image 2.1 · 8 créditos por imagen
- Página actualizada
- 20 de octubre de 2026
Fuente: github.com
¿Qué es MOSS-Image?
MOSS-Image es un modelo de texto a imagen que OpenMOSS (MOSI.AI) lanzó el 16 de octubre de 2026, junto con investigadores de la Universidad Fudan, la Universidad Jiao Tong de Shanghái y el Shanghai Innovation Institute. Combina un transformer de difusión de 5 mil millones de parámetros, entrenado desde cero, con el modelo de lenguaje Qwen3.5-9B como codificador de texto y el VAE de FLUX.2.
Se distribuye en dos checkpoints. MOSS-Image-Base se deja sin postentrenamiento para que sea fácil hacerle ajuste fino; MOSS-Image-SFT tiene ajuste fino con datos seleccionados para lograr un texto y una maquetación más limpios. Ambos se publican bajo la licencia Apache 2.0, que permite el uso comercial.
MOSS-Image solo convierte texto en imágenes: su informe técnico indica que no admite imágenes de referencia ni edita fotos. Para usarlo hay que descargar los pesos, unos 13 GB en los archivos compactos de ComfyUI o 27 GB en precisión completa, y ejecutarlos en ComfyUI, Diffusers, SGLang o vLLM-Omni. Si solo quieres imágenes con texto limpio en chino e inglés, el generador de la parte superior de esta página ejecuta Qwen Image 2.1 en el navegador.
Especificaciones de MOSS-Image
- Desarrollador
- OpenMOSS (MOSI.AI)
- Lanzamiento
- 16 de octubre de 2026
- Licencia
- Apache 2.0, con uso comercial permitido
- Modelo de imagen
- Transformer de difusión de flujo único de 5B, 42 bloques
- Codificador de texto
- Qwen3.5-9B (congelado)
- VAE
- VAE de FLUX.2 con el decodificador pequeño
- Checkpoints
- MOSS-Image-Base y MOSS-Image-SFT
- Formatos de prompt
- Lenguaje natural, listas de etiquetas y maquetaciones en JSON (experimental), hasta 4,096 tokens
- Resolución
- Se recomiendan de 1 a 2 megapíxeles; de 512 × 512 hasta 2K, con lados múltiplos de 16
- Edición de imágenes
- No compatible
- Muestreo predeterminado
- Euler, 50 pasos, CFG 3, shift 5, skip layer 22
- En Nano AI
- No está alojado; en su lugar se usa Qwen Image 2.1, 8 créditos por imagen
Ejemplos de MOSS-Image
Recortados de las imágenes de demostración de la ficha de modelo de OpenMOSS, sin retoques. OpenMOSS no publicó los prompts, así que cada pie de foto describe la imagen.
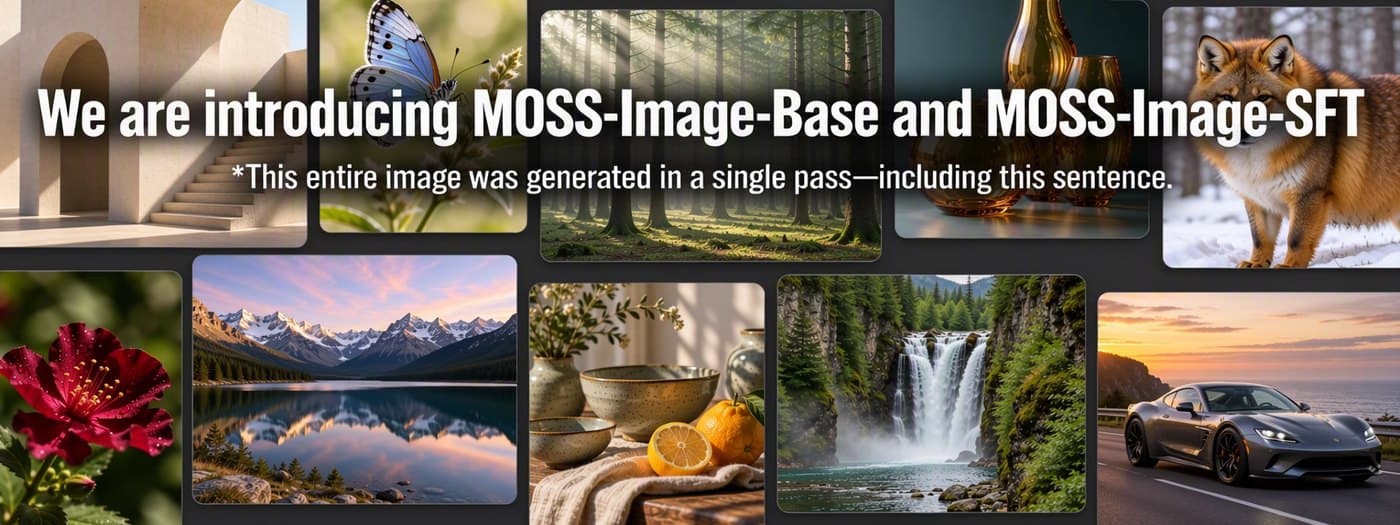
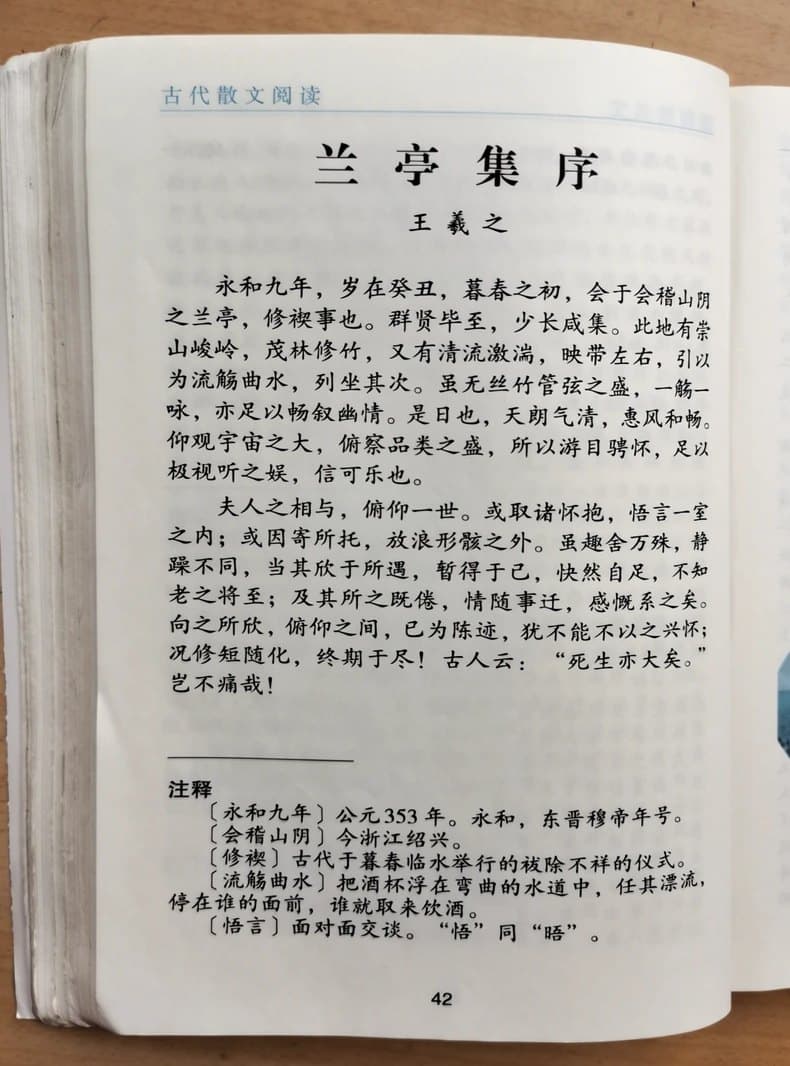
Qué hace bien MOSS-Image y dónde flaquea
Textos largos que se leen correctamente
En el benchmark de texto largo de OpenMOSS (LLTB), MOSS-Image obtiene 96.3, a la par de Nano Banana Pro con 96.6 y muy por delante de modelos abiertos como Qwen Image 2512 (64.9) y Z-Image Base (40.8). Quienes lo han probado señalan pocas faltas de ortografía en inglés y en japonés.
Elementos colocados por coordenadas
Un prompt en JSON puede asignar a cada bloque de texto y a cada objeto su propio recuadro. En la prueba de maquetación 7Bench, MOSS-Image alcanza 0.88 de mIoU, frente a entre 0.30 y 0.33 de GPT Image 2, Nano Banana Pro, Seedream 5.0 Pro y Qwen Image 3.0 Pro.
Cabe en una sola GPU de consumo
Con los archivos de 8 bits, el modelo de 5B funcionó en una RTX 4070 de 12 GB en pruebas de la comunidad, y las versiones de 4 bits o GGUF funcionan en tarjetas de 8 GB con offloading.
Pensado para el ajuste fino
El modelo Base se distribuye sin postentrenamiento. KohakuMossTrainer y DiffSynth-Studio ya entrenan LoRAs, y la comunidad ha publicado versiones de 8 y de 4 pasos.
Lento con la configuración predeterminada
50 pasos, con dos pasadas cada uno, tardan unos 27 segundos por imagen de 1024 × 1024 en una RTX 5090 en precisión completa, y unos 50 segundos en una RTX 4070 de 12 GB con archivos de 8 bits.
Puntos débiles conocidos
Los usuarios señalan bandas verticales de color en las imágenes de SFT, fondos borrosos, manos deformes, texto de más que nadie pidió y problemas para contar. No puede editar imágenes.
MOSS-Image frente a Qwen Image 2.1, Nano Banana Pro y GPT Image 2
Las puntuaciones de los benchmarks proceden del informe técnico de MOSS-Image (arXiv 2610.23374) y las midió el propio equipo de OpenMOSS; Qwen Image 2.1 no se incluyó. Los créditos son precios de Nano AI al 20 de octubre de 2026.
| MOSS-Image | Qwen Image 2.1 | Nano Banana Pro | GPT Image 2 | |
|---|---|---|---|---|
| Desarrollador | OpenMOSS | Alibaba | OpenAI | |
| Pesos | Abiertos, Apache 2.0 | Abiertos | Cerrados | Cerrados |
| Puntuación en texto largo (LLTB) | 96.3 | No evaluado | 96.6 | 99.0 |
| Elo de preferencia humana (RLA) | 1698.7, con GPT-6 como mejorador de prompts | No evaluado | 1590.2 | 1844.4 |
| Edición de imágenes | No | Sí | Sí | Sí |
| Dónde ejecutarlo | En tu propia GPU | Nano AI, 8 créditos | Nano AI, 32 créditos | Nano AI, 12 créditos |
Cómo ejecutar MOSS-Image
- 1
En ComfyUI
Actualiza a ComfyUI 0.42.0 o posterior, descarga el modelo de difusión, el codificador de texto Qwen3.5-9B y el VAE de FLUX.2 desde Comfy-Org/MOSS-Image, y abre una plantilla de MOSS-Image. Nuestra guía de ComfyUI MOSS-Image, enlazada más abajo, detalla cada archivo y cada ajuste.
- 2
Con Python
En una GPU NVIDIA, instala diffusers 0.38 o posterior y carga OpenMOSS-Team/MOSS-Image-SFT con el pipeline personalizado incluido. SGLang y vLLM-Omni también pueden servir el modelo.
- 3
Sin GPU
Prueba la demo gratuita de OpenMOSS en Hugging Face Spaces, que puede tener cola, o el generador de la parte superior de esta página, que ejecuta Qwen Image 2.1, el modelo con el que más se compara MOSS-Image.
Consejos de prompts para MOSS-Image
Escribe en inglés siempre que puedas, porque es el idioma con más datos de entrenamiento; pon las palabras exactas entre comillas y añade saltos de línea donde los quieras. Los cuatro primeros también funcionan en el generador de arriba.
Nota manuscrita en chino
A wide view of a refrigerator beside a kitchen counter with a fruit bowl. A small sticky note on the refrigerator door is handwritten in Chinese: "记得买牛奶和鸡蛋! 牛奶两盒,鸡蛋一打。 顺便带一袋面包。"
Letrero bilingüe de tienda
A small tea shop at dusk with a wooden sign that reads "山间茶舍" on the first line and "Mountain Tea House" on the second line, warm lantern light, wet stone steps, no people
Notas en una pizarra blanca
A glass whiteboard in a bright office with neat handwritten notes in blue marker: "Q4 plan 1. Ship the layout editor 2. Train a style LoRA 3. Publish the user guide", soft daylight, no people
Título de póster
A minimalist travel poster with a cream background, a blue mountain illustration, and the title "EXPLORE" at the top.
Lista de etiquetas (MOSS-Image)
best quality, highres, scenery, mountain lake, sunrise, mist, no humans
Preguntas frecuentes
Preguntas frecuentes sobre MOSS-Image
Respuestas breves sobre el modelo, cómo ejecutarlo y cómo usar algo parecido online.
¿MOSS-Image es gratis?
Sí. Los pesos y el código son gratuitos bajo la licencia Apache 2.0, también para uso comercial. Solo pagas la GPU en la que lo ejecutes. OpenMOSS también ofrece una demo gratuita en Hugging Face Spaces.
¿Puedo usar MOSS-Image online sin GPU?
La demo de OpenMOSS en Hugging Face es la única opción oficial, y puede tener cola. Nano AI no aloja MOSS-Image; el generador de esta página ejecuta Qwen Image 2.1, que se le acerca en texto dentro de las imágenes y además puede editar fotos. En la mayoría de las regiones, las cuentas nuevas reciben 16 créditos gratis, suficientes para 2 imágenes.
¿Cuánta VRAM necesita MOSS-Image?
OpenMOSS no ha publicado una cifra. En pruebas de la comunidad, los archivos en precisión completa llegaron a un pico de unos 29 GiB en una RTX 5090; los de 8 bits, a unos 16 GiB en la misma tarjeta y a unos 11.6 GiB en una RTX 4070 de 12 GB. Las versiones de 4 bits y GGUF funcionan en tarjetas de 8 GB con offloading, aunque más despacio.
MOSS-Image Base o SFT: ¿cuál debo descargar?
SFT para crear imágenes: tiene ajuste fino para agrupar el texto y maquetar con más limpieza. Base es el checkpoint sin retocar, pensado para entrenar LoRAs y para investigación.
¿MOSS-Image puede editar imágenes?
No. El informe técnico indica que no admite imágenes de referencia ni edita imágenes, y OpenMOSS dice que la generación a partir de referencias todavía está en estudio. Para editar, usa un modelo como Qwen Image 2.1 o Nano Banana 2.1.
¿ComfyUI es compatible con MOSS-Image?
Sí, de forma nativa desde ComfyUI 0.42.0, publicado el 18 de octubre de 2026. La versión 0.41.3 no lo incluye. Nuestra guía de ComfyUI MOSS-Image detalla los archivos, las carpetas y los ajustes.
¿Quién creó MOSS-Image?
OpenMOSS, el equipo de MOSI.AI detrás de los modelos MOSS, con investigadores de la Universidad Fudan, la Universidad Jiao Tong de Shanghái y el Shanghai Innovation Institute. El informe técnico es arXiv 2610.23374.
¿Nano AI está afiliado a OpenMOSS?
No. Nano AI es un servicio independiente. Enlaza a las descargas oficiales de OpenMOSS y no aloja MOSS-Image.
Más en Nano AI
Páginas relacionadas
Nano AI es un servicio independiente y no está afiliado a OpenMOSS ni a MOSI.AI, ni cuenta con su respaldo o patrocinio. Los datos y las puntuaciones en benchmarks de MOSS-Image proceden de las fichas de modelo, el repositorio de GitHub y el informe técnico de OpenMOSS, consultados el 20 de octubre de 2026; las cifras de hardware son mediciones de la comunidad. Las imágenes de ejemplo proceden de la ficha de modelo de OpenMOSS y se usan bajo la licencia Apache 2.0.