
Mis à jour le 20 octobre 2026 · ComfyUI 0.42.0+ · Aucun nœud personnalisé
Guide ComfyUI MOSS-Image : installer, télécharger et lancer
Depuis la version 0.42.0, ComfyUI prend en charge MOSS-Image de façon native. Ce guide ComfyUI MOSS-Image liste les fichiers exacts, le dossier où va chacun, la VRAM qu'ils demandent, les workflows officiels et les solutions aux erreurs les plus fréquentes.
Pas de GPU, ou pas le temps de télécharger 13 GB ?
Essayez Qwen Image 2.1 en ligne : un rendu du texte similaire, rien à installer
Installer ComfyUI MOSS-Image demande un téléchargement de 13 GB et un GPU de 12 GB ou plus. Qwen Image 2.1 est le modèle auquel MOSS-Image est le plus souvent comparé : tous deux écrivent du texte chinois et anglais dans les images, et les tests côte à côte donnent des résultats proches. Sur Nano AI, il tourne dans votre navigateur pour 8 crédits par image, et il sait aussi retoucher des photos, ce dont MOSS-Image est incapable.
- Développé par
- OpenMOSS
- Sortie
- 16 octobre 2026
- Disponible sur Nano AI
- Qwen Image 2.1 · 8 crédits par image
- Page mise à jour
- 20 octobre 2026
Source: github.com
Ce qu'il vous faut pour ComfyUI MOSS-Image
MOSS-Image est le modèle texte-image ouvert d'OpenMOSS : un transformeur de diffusion de 5B avec l'encodeur de texte Qwen3.5-9B et le VAE FLUX.2, publié sous Apache 2.0 le 16 octobre 2026. Sa prise en charge a été fusionnée dans ComfyUI le jour même (pull request 17095) et livrée pour la première fois dans la version stable 0.42.0, le 18 octobre. Les versions 0.41.3 et antérieures ne peuvent pas le charger.
Avec la prise en charge native, aucun nœud personnalisé (custom node) n'est nécessaire. Les nœuds standard Load Diffusion Model, CLIP Loader et Load VAE lisent les fichiers reconditionnés de Comfy-Org/MOSS-Image, et ComfyUI ajoute un nœud MOSS-Image Layout Prompt pour les mises en page JSON.
Le plugin MOSS-Image d'OpenMOSS reste disponible si vous voulez charger le dossier Hugging Face d'origine ou conserver un ancien workflow du plugin. Pour une nouvelle installation de ComfyUI MOSS-Image, suivez la voie native ci-dessous.
Configuration requise pour ComfyUI MOSS-Image
- ComfyUI
- 0.42.0 ou ultérieure, ou une version nightly incluant le commit e087d8f6
- Nœuds personnalisés
- Aucun pour la voie native
- Téléchargement minimal
- Environ 13 GB : modèle 8 bits, encodeur de texte 4 bits, petit VAE
- Téléchargement en pleine précision
- Environ 30 GB : modèle et encodeur de texte en bf16
- Mémoire GPU
- 12 GB ont suffi avec les fichiers 8 bits lors de tests de la communauté ; 16 GB ou plus pour être à l'aise
- Réglages des templates
- 25 étapes, CFG 2.5, er_sde, scheduler simple
- Réglages d'OpenMOSS
- 50 étapes, CFG 3, Euler, shift 5, skip layer 22
- Résolution
- 1 à 2 mégapixels, côtés multiples de 16
- Retouche d'images
- Non prise en charge par le modèle
- Licence
- Apache 2.0
Comment installer ComfyUI MOSS-Image
La voie native ne demande aucun nœud personnalisé. Les commandes supposent une installation de ComfyUI via git ; ComfyUI Desktop se met à jour tout seul, et la version portable se met à jour avec update/update_comfyui.bat.
- 1
Mettez ComfyUI à jour en 0.42.0 ou ultérieure
La prise en charge de MOSS-Image a été fusionnée le 16 octobre 2026 et publiée pour la première fois dans la 0.42.0, le 18 octobre. Mettez à jour, puis réinstallez les dépendances pour que le nouveau code de l'encodeur de texte soit en place.
cd ComfyUI git pull pip install -r requirements.txt - 2
Téléchargez un fichier de chaque type
Il vous faut un modèle de diffusion, un encodeur de texte et un VAE issus de Comfy-Org/MOSS-Image. Ces trois fichiers sont ceux que chargent les templates officiels, soit environ 13 GB au total. La CLI de Hugging Face les place directement dans les bons dossiers :
pip install -U huggingface_hub hf download Comfy-Org/MOSS-Image \ diffusion_models/moss_image_sft_int8_convrot.safetensors \ text_encoders/qwen3.5_9b_w4a8_gptq.safetensors \ vae/flux2-vae_small.safetensors \ --local-dir ComfyUI/models - 3
Vérifiez les dossiers
Chaque fichier se trouve dans son propre dossier sous ComfyUI/models. Redémarrez ComfyUI, ou appuyez sur R dans l'interface pour actualiser les listes de modèles.
ComfyUI/models/diffusion_models/moss_image_sft_int8_convrot.safetensors ComfyUI/models/text_encoders/qwen3.5_9b_w4a8_gptq.safetensors ComfyUI/models/vae/flux2-vae_small.safetensors - 4
Ouvrez un template ComfyUI MOSS-Image
Ouvrez Templates, cherchez MOSS-Image et choisissez l'un des quatre workflows officiels : MOSS-Image Text to Image, MOSS-Image Base Text to Image, ou la version Layout-Guided de l'un ou de l'autre.
- 5
Vérifiez les nœuds de chargement et lancez
Load Diffusion Model prend le fichier moss_image, CLIP Loader prend le fichier qwen3.5_9b avec le type réglé sur moss_image, et Load VAE prend flux2-vae_small. Écrivez un prompt et cliquez sur Run. Les templates utilisent 25 étapes, CFG 2.5 et er_sde ; les réglages de référence d'OpenMOSS sont 50 étapes, CFG 3, Euler, shift 5 et skip layer 22.
- 6
Facultatif : le plugin d'OpenMOSS pour le dossier d'origine
Pour charger plutôt le dossier Hugging Face complet (environ 27 GB), installez le plugin MOSS-Image depuis ComfyUI Manager, ou reliez-le à ComfyUI avec le script ci-dessous, puis pointez le nœud MOSS-Image HF Loader vers ce dossier.
git clone https://github.com/OpenMOSS/MOSS-Image.git
cd MOSS-Image
python comfyui/install.py --comfy-root /path/to/ComfyUI
Fichiers du modèle ComfyUI MOSS-Image
Tous les fichiers se trouvent dans Comfy-Org/MOSS-Image sur Hugging Face (Apache 2.0). Choisissez un modèle de diffusion, un encodeur de texte et un VAE. Tailles relevées le 20 octobre 2026.
| Fichier | Dossier dans ComfyUI/models | Taille | Quand le choisir |
|---|---|---|---|
| moss_image_sft_int8_convrot.safetensors | diffusion_models | 5.41 GB | Le choix par défaut des templates officiels : le modèle affiné en 8 bits |
| moss_image_sft_bf16.safetensors | diffusion_models | 10.2 GB | Le modèle affiné en pleine précision, si vous avez assez de VRAM |
| moss_image_base_int8_convrot.safetensors | diffusion_models | 5.41 GB | Le modèle Base en 8 bits, pour les LoRA entraînés sur Base |
| moss_image_base_bf16.safetensors | diffusion_models | 10.2 GB | Le modèle Base en pleine précision, pour l'entraînement et la recherche |
| qwen3.5_9b_w4a8_gptq.safetensors | text_encoders | 7.34 GB | Le plus petit encodeur de texte, utilisé par les templates officiels |
| qwen3.5_9b_int8_convrot.safetensors | text_encoders | 9.75 GB | L'encodeur de texte en 8 bits |
| qwen3.5_9b_bf16.safetensors | text_encoders | 19.3 GB | L'encodeur de texte en pleine précision |
| flux2-vae_small.safetensors | vae | 250 MB | Le petit décodeur fourni avec le pipeline et les templates officiels |
| flux2-vae.safetensors | vae | 336 MB | Le VAE FLUX.2 complet |
Ce que produit MOSS-Image
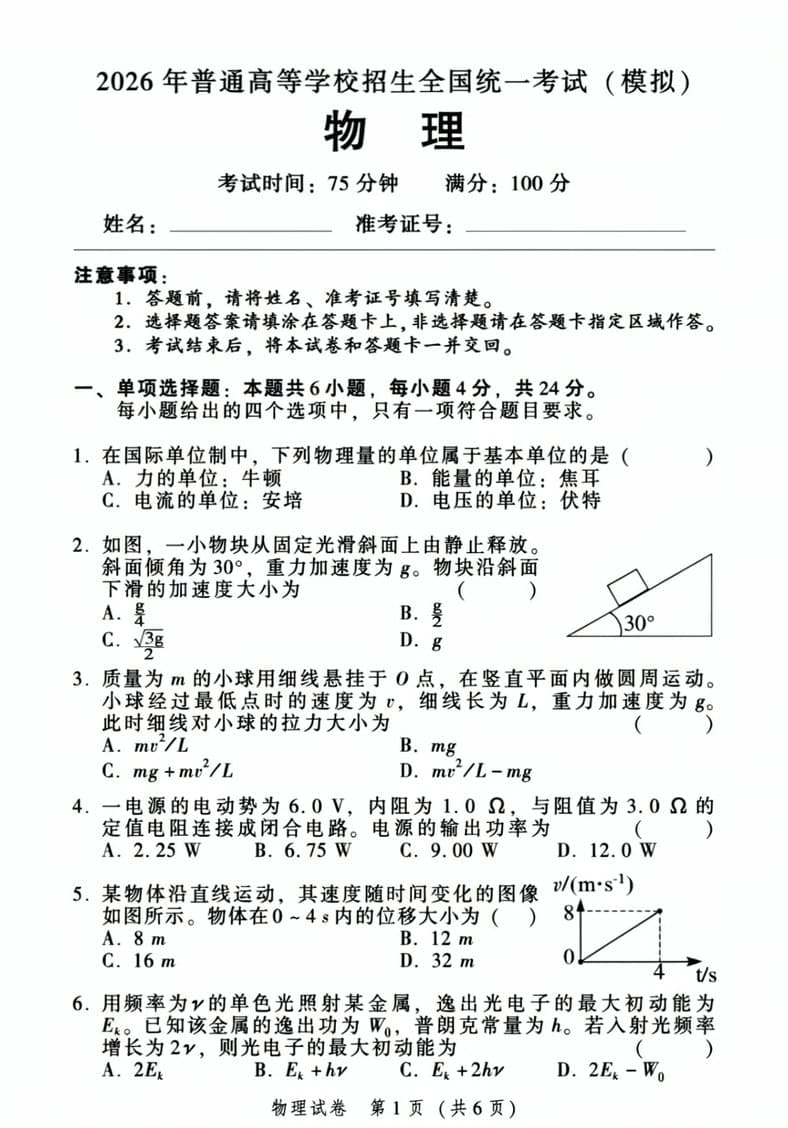
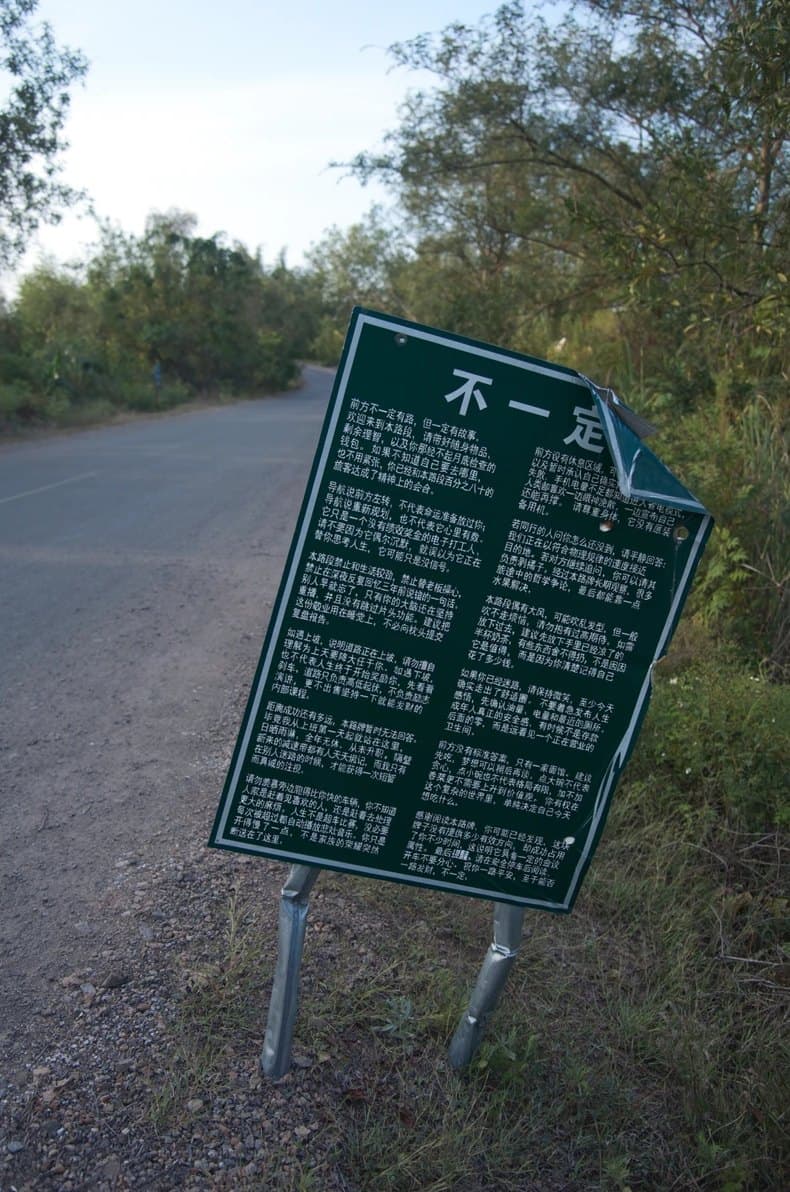
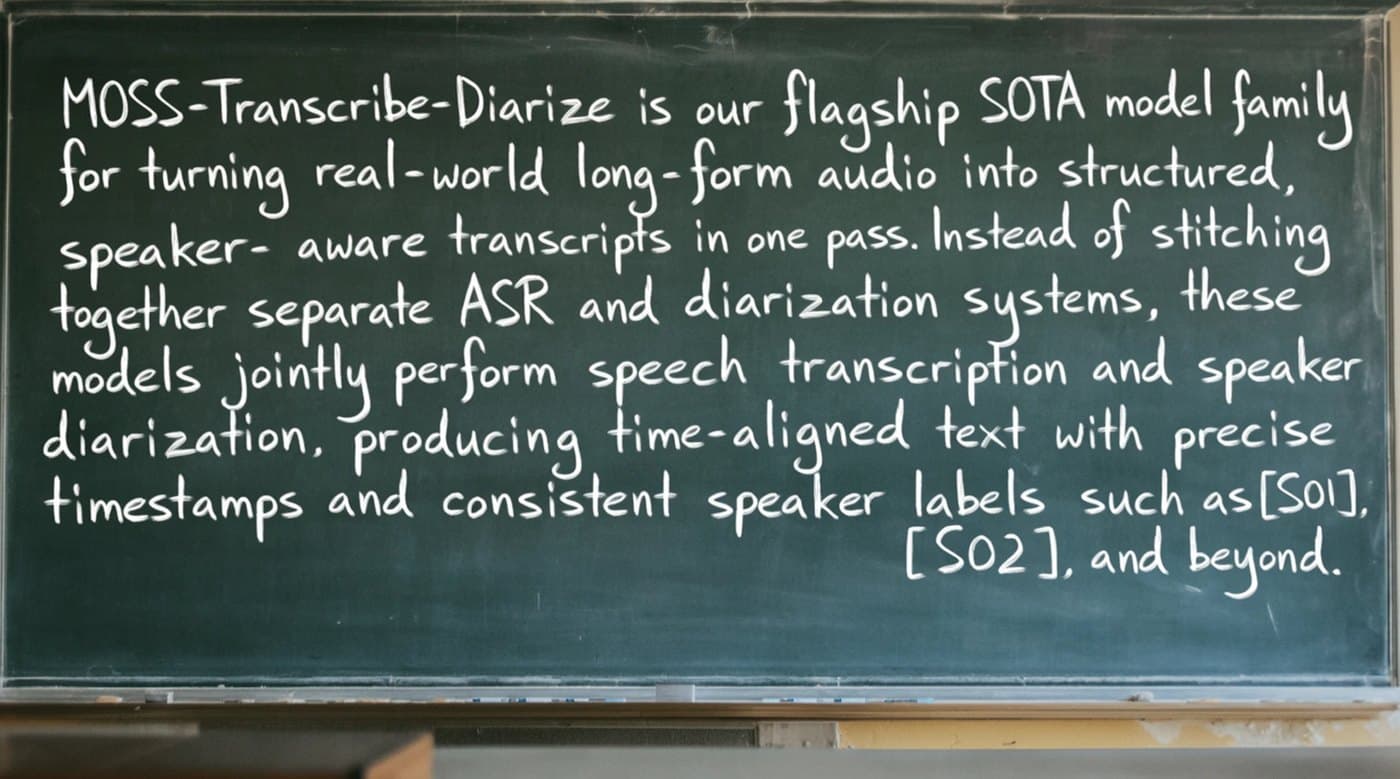
C'est sur les textes denses en chinois et en anglais que MOSS-Image se distingue. Ces images sont extraites de la vitrine de la fiche modèle d'OpenMOSS, sans retouche ; les prompts n'ont pas été publiés, chaque légende décrit donc l'image.
Réglages recommandés pour ComfyUI MOSS-Image
Étapes : 25 à 50
OpenMOSS en recommande 50 ou plus. Les templates ComfyUI en utilisent 25 avec le sampler er_sde, ce qui prend environ deux fois moins de temps.
CFG : 2.5 à 6
3 est la valeur officielle par défaut et suffit pour les longs prompts ; augmentez-la pour les prompts courts. Les LoRA en 8 et 4 étapes utilisent CFG 1.
Shift : 5
Intégré au modèle natif. Si vous le modifiez, utilisez ModelSamplingAuraFlow au multiplicateur 1, et non ModelSamplingSD3.
Skip layer guidance : couche 22
Sauter la couche 22 lors de la passe négative améliore les détails ; les couches 24 et 26 fonctionnent aussi. Sans cette option, le rendu est plus photographique, mais les détails peuvent se désagréger.
Résolution : 1 à 2 mégapixels
De 1024 × 1024 à environ 1456 × 1456, dans n'importe quel ratio d'aspect, avec des côtés multiples de 16. Le modèle peut aller de 512 × 512 jusqu'à 2K.
Prompt négatif : des tags courts
Laissez-le vide, ou utilisez les tags de qualité du guide d'utilisation d'OpenMOSS : worst quality, bad anatomy, watermark, jpeg artifact.
ComfyUI MOSS-Image : vitesse et VRAM dans les tests de la communauté
OpenMOSS n'a pas publié de chiffres de VRAM. Voici des mesures partagées sur YouTube, note.com, X et Hugging Face dans la semaine qui a suivi la sortie ; le pic de mémoire concerne l'ensemble du GPU.
| Fichiers du modèle | Taille et étapes | Temps par image | Pic de VRAM | |
|---|---|---|---|---|
| RTX 5090, pleine précision | SFT bf16 | 1024 × 1024, 50 étapes | 27.4 s | 29.2 GiB |
| RTX 5090, 8 bits | SFT int8 | 1024 × 1024, 50 étapes | 10.5 s | 16.4 GiB |
| RTX 5090, étapes du template | int8 | 1 mégapixel, 25 étapes | 5.7 s | Non communiqué |
| RTX 4070 12 GB | Base int8, encodeur de texte int8 | 832 × 1216, 50 étapes | 50 à 52 s | 11.6 GiB |
| RTX 3060 Ti 8 GB | int8 | 720p, 50 étapes | 52 s | Non communiqué |
| DGX Spark | Non communiqué | 1024 × 1024, 25 et 50 étapes | 30 s et 48 s | Non communiqué |
Workflows, outils et tutoriels ComfyUI MOSS-Image
Les sources officielles d'abord, puis les projets de la communauté, tous vérifiés le 20 octobre 2026.
Comment écrire des prompts pour ComfyUI MOSS-Image
- 1
Décrivez la scène en anglais
L'anglais est la langue la mieux représentée dans les données d'entraînement. Décrivez le sujet, le décor, l'éclairage et le style ; un prompt peut aller jusqu'à 4,096 tokens.
- 2
Mettez le texte voulu entre guillemets
Mettez la formulation exacte entre guillemets et ajoutez des retours à la ligne là où les lignes doivent se couper. Le chinois comme l'anglais fonctionnent.
- 3
Placez les éléments avec une mise en page
Pour les affiches et les pages, utilisez le template Layout-Guided ou une mise en page JSON : une légende de synthèse, puis des éléments avec des zones en pixels mesurées à partir du centre du canevas.
Prompts ComfyUI MOSS-Image pour bien démarrer
Collez-les dans le prompt positif, ou dans le prompt négatif quand c'est indiqué. L'exemple de mise en page est prévu pour un canevas de 1024 × 1024.
Mise en page JSON (exemple officiel)
{"summary": {"meta": ["poster"], "canvas": "single", "caption": "A minimalist travel poster with a cream background, a blue mountain illustration, and the title EXPLORE at the top."}, "items": [{"label": "text", "caption": "Large dark-blue uppercase title centered at the top.", "text": "EXPLORE", "bbox": [-416, -384, -288, 384]}, {"label": "object", "caption": "A flat blue mountain illustration in the lower center.", "bbox": [-192, -288, 384, 288]}], "bbox_coord_space": "abs_centralized", "bbox_format": "yxyx"}
Page imprimée avec formules
A printed physics exam page in Chinese titled "物理" with numbered multiple-choice questions, a small diagram of a block on a 30° slope and the footer "物理试卷 第1页(共6页)", flat scan, black ink on white paper
Ordre des tags
best quality, highres, scenery, night city, river, skyline reflections, long exposure, no humans
Prompt négatif (tags de qualité)
worst quality, bad anatomy, watermark, jpeg artifact
Erreurs ComfyUI MOSS-Image et solutions
Les problèmes les plus souvent signalés dans les premiers jours après la sortie, et ce qui les a résolus.
- CLIP Loader ne propose pas le type moss_image
- Votre ComfyUI est antérieur à la 0.42.0 ; la 0.41.3 n'inclut pas MOSS-Image. Mettez à jour, relancez pip install -r requirements.txt et redémarrez.
- Résultats étranges après avoir quitté le plugin
- Les workflows du plugin utilisent ModelSamplingSD3, dont l'échelle de timesteps est différente. Ouvrez un template natif au lieu de remplacer les nœuds de chargement, et modifiez le shift avec ModelSamplingAuraFlow au multiplicateur 1.
- Images grises et délavées
- Retirez --use-sage-attention de vos options de lancement. Des utilisateurs, sur la page du modèle de Comfy-Org, signalent que cette option désature les images produites par MOSS-Image.
- Mémoire insuffisante
- Utilisez le modèle 8 bits, l'encodeur de texte 4 bits et flux2-vae_small, restez autour de 1 mégapixel et laissez ComfyUI gérer le déchargement, ou lancez-le avec --lowvram.
- Rayures verticales sur les images SFT
- Un problème connu de SFT. Essayez le LoRA DeBand de la communauté, le correctif à poids négatif de Kijai, ou le modèle Base.
- Images noires
- Le plus souvent un dépassement de capacité en fp16 à haute résolution. Travaillez en bf16, ou utilisez les poids FP16-fixed de KBlueLeaf.
- Génération très lente
- 50 étapes avec skip layer guidance, cela fait deux passes par étape. Utilisez les 25 étapes du template, un LoRA en 8 ou 4 étapes à CFG 1, ou les nœuds Spectrum.
- Mots erronés ou manquants
- Mettez le texte exact entre guillemets, ajoutez des retours à la ligne là où les lignes doivent se couper, écrivez le reste du prompt en anglais et montez le CFG vers 4 à 6 pour les prompts courts.
- L'image de référence ne change rien
- MOSS-Image ne sait pas utiliser d'images de référence. Dans les templates, ref_image alimente seulement l'enrichisseur de prompt facultatif.
- Même seed, image différente de celle de Python
- C'est normal. Le scheduler de ComfyUI ne s'aligne pas sur la grille d'entraînement qu'utilise le pipeline Python, si bien que les résultats diffèrent.
Pas de GPU, ou pas le temps de télécharger 13 GB ?
Essayez Qwen Image 2.1 en ligne : un rendu du texte similaire, rien à installer
Installer ComfyUI MOSS-Image demande un téléchargement de 13 GB et un GPU de 12 GB ou plus. Qwen Image 2.1 est le modèle auquel MOSS-Image est le plus souvent comparé : tous deux écrivent du texte chinois et anglais dans les images, et les tests côte à côte donnent des résultats proches. Sur Nano AI, il tourne dans votre navigateur pour 8 crédits par image, et il sait aussi retoucher des photos, ce dont MOSS-Image est incapable.
FAQ
FAQ ComfyUI MOSS-Image
Des réponses courtes aux questions les plus fréquentes sur l'utilisation de MOSS-Image dans ComfyUI.
Quelle version de ComfyUI prend en charge MOSS-Image ?
La 0.42.0, sortie le 18 octobre 2026, ou une version nightly à partir du 16 octobre (commit e087d8f6). La 0.41.3 ne le prend pas en charge, même si certains guides affirment le contraire.
Faut-il un nœud personnalisé pour MOSS-Image dans ComfyUI ?
Non. Depuis la 0.42.0, les nœuds de chargement standard lisent les fichiers de Comfy-Org/MOSS-Image. Le plugin d'OpenMOSS ne sert qu'à charger le dossier Hugging Face d'origine.
De combien de VRAM ComfyUI MOSS-Image a-t-il besoin ?
Il n'existe pas de chiffre officiel. Avec le modèle 8 bits et l'encodeur de texte 4 bits, une carte de 12 GB a suffi lors de tests de la communauté, et les cartes de 8 GB font tourner des configurations 4 bits ou GGUF avec déchargement, lentement. En pleine précision, le pic a atteint environ 29 GiB sur une RTX 5090.
Existe-t-il une version GGUF ou fp8 de MOSS-Image ?
Pas chez OpenMOSS ni chez Comfy-Org, qui proposent à la place des fichiers 8 bits (int8) et 4 bits (w4a8). Des fichiers GGUF de la communauté existent, mais ils nécessitent des nœuds personnalisés supplémentaires, et Comfy-Org a indiqué que le GGUF ne serait pas pris en charge nativement.
Où placer les fichiers ComfyUI MOSS-Image ?
Sous ComfyUI/models : les fichiers moss_image dans diffusion_models, les fichiers qwen3.5_9b dans text_encoders et les fichiers flux2-vae dans vae.
Base ou SFT pour ComfyUI MOSS-Image ?
SFT pour les images du quotidien. Base pour entraîner des LoRA, ou quand un LoRA a été entraîné sur Base.
ComfyUI MOSS-Image peut-il retoucher des images ou utiliser une image de référence ?
Non, il ne fait que de la génération d'images à partir de texte. Pour les retouches, Qwen Image 2.1 et Nano Banana 2.1 sur Nano AI acceptent jusqu'à 5 images de référence.
Peut-on obtenir des résultats similaires sans rien installer ?
Oui. Essayez la démo Hugging Face d'OpenMOSS, ou Qwen Image 2.1 sur Nano AI, le modèle auquel MOSS-Image est le plus souvent comparé pour le texte dans les images. Dans la plupart des régions, les nouveaux comptes reçoivent 16 crédits offerts, de quoi générer 2 images Qwen Image 2.1.
À découvrir aussi sur Nano AI
Pages associées
Nano AI est un service indépendant, sans lien d'affiliation avec OpenMOSS, MOSI.AI ou Comfy Org. Les noms de fichiers, les tailles et les versions proviennent de Hugging Face, de GitHub et des notes de version de ComfyUI, consultés le 20 octobre 2026 ; les chiffres de vitesse et de VRAM sont des mesures de la communauté. Les exemples d'images proviennent de la fiche modèle d'OpenMOSS et sont utilisés sous licence Apache 2.0.