
OpenMOSS · Sorti le 16 octobre 2026 · Apache 2.0
MOSS-Image : le modèle ouvert pour le texte et la mise en page dans les images
MOSS-Image est un modèle texte-image à poids ouverts de 5B signé OpenMOSS : il écrit de longs textes en chinois et en anglais dans les images et suit des mises en page JSON. Ci-dessous : fiche technique, scores de benchmark, exemples d'images et comment le faire tourner.
MOSS-Image tourne sur votre propre GPU : Nano AI ne l'héberge donc pas. Le modèle auquel on le compare le plus souvent est Qwen Image 2.1, tout aussi centré sur le texte chinois et anglais dans les images. C'est lui que fait tourner ce générateur : 8 crédits par image, sans GPU.
16 crédits offerts = 2 images standard. Sans carte bancaire.
Tableau des résultats
Vos variantes générées s'afficheront ici.
- Développé par
- OpenMOSS
- Sortie
- 16 octobre 2026
- Disponible sur Nano AI
- Qwen Image 2.1 · 8 crédits par image
- Page mise à jour
- 20 octobre 2026
Source: github.com
Qu'est-ce que MOSS-Image ?
MOSS-Image est un modèle de génération d'images à partir de texte publié le 16 octobre 2026 par OpenMOSS (MOSI.AI), avec des chercheurs de l'université Fudan, de l'université Jiao Tong de Shanghai et du Shanghai Innovation Institute. Il associe un transformeur de diffusion de 5 milliards de paramètres, entraîné à partir de zéro, au modèle de langage Qwen3.5-9B, qui sert d'encodeur de texte, et au VAE de FLUX.2.
Il se décline en deux checkpoints. MOSS-Image-Base n'a pas subi de post-entraînement, ce qui le rend facile à affiner ; MOSS-Image-SFT est affiné sur des données sélectionnées pour un texte et une mise en page plus propres. Les deux sont publiés sous licence Apache 2.0, qui autorise l'usage commercial.
MOSS-Image ne fait que transformer du texte en images : son rapport technique précise qu'il ne peut ni prendre d'images de référence ni retoucher des photos. Pour l'utiliser, vous téléchargez les poids, environ 13 GB dans les fichiers compacts de ComfyUI ou 27 GB en pleine précision, puis vous les faites tourner dans ComfyUI, Diffusers, SGLang ou vLLM-Omni. Si vous voulez simplement des images avec un texte chinois et anglais propre, le générateur en haut de cette page fait tourner Qwen Image 2.1 dans votre navigateur.
Fiche technique de MOSS-Image
- Développeur
- OpenMOSS (MOSI.AI)
- Date de sortie
- 16 octobre 2026
- Licence
- Apache 2.0, usage commercial autorisé
- Modèle d'image
- Transformeur de diffusion à flux unique de 5B, 42 blocs
- Encodeur de texte
- Qwen3.5-9B (gelé)
- VAE
- VAE FLUX.2 avec le petit décodeur
- Checkpoints
- MOSS-Image-Base et MOSS-Image-SFT
- Formats de prompt
- Langage naturel, listes de tags et mises en page JSON (expérimental), jusqu'à 4,096 tokens
- Résolution
- 1 à 2 mégapixels recommandés ; de 512 × 512 jusqu'à 2K, côtés multiples de 16
- Retouche d'images
- Non prise en charge
- Échantillonnage par défaut
- Euler, 50 étapes, CFG 3, shift 5, skip layer 22
- Sur Nano AI
- Non hébergé ; Qwen Image 2.1 tourne à sa place, 8 crédits par image
Exemples d'images MOSS-Image
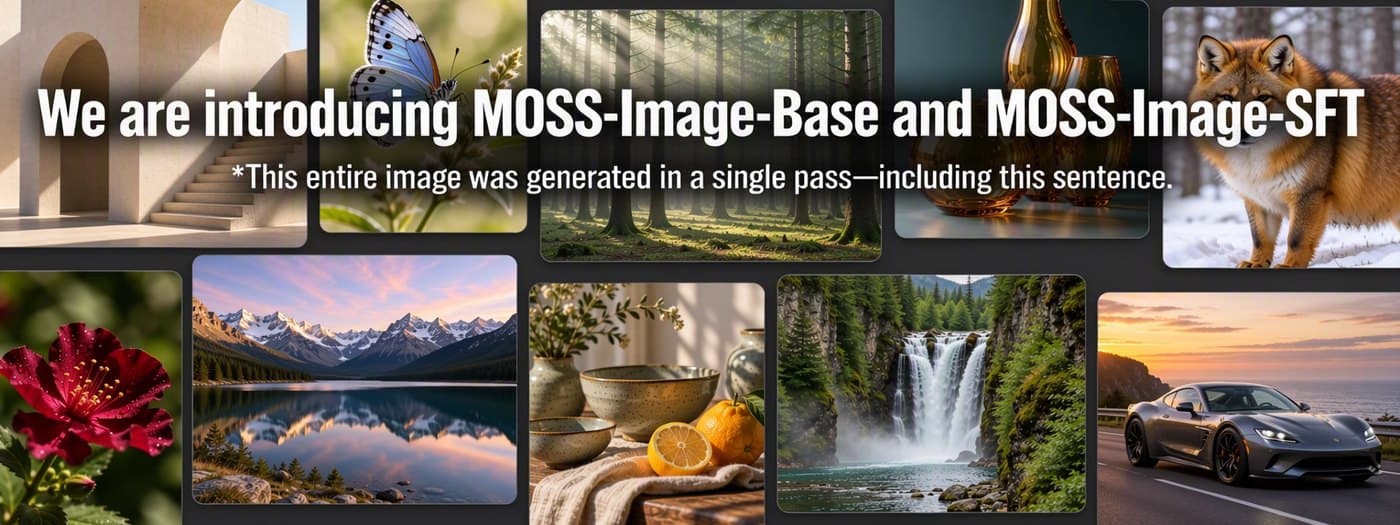
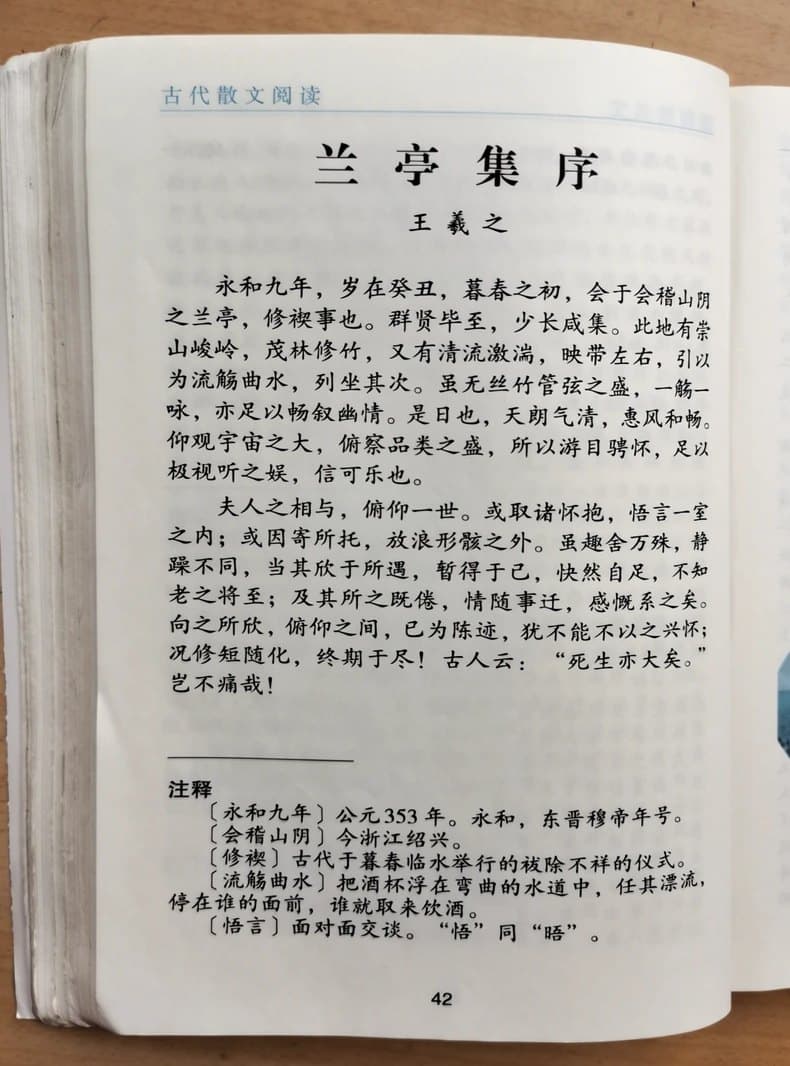
Extraits des images de démonstration de la fiche modèle d'OpenMOSS, sans retouche. OpenMOSS n'a pas publié les prompts : chaque légende décrit donc l'image.
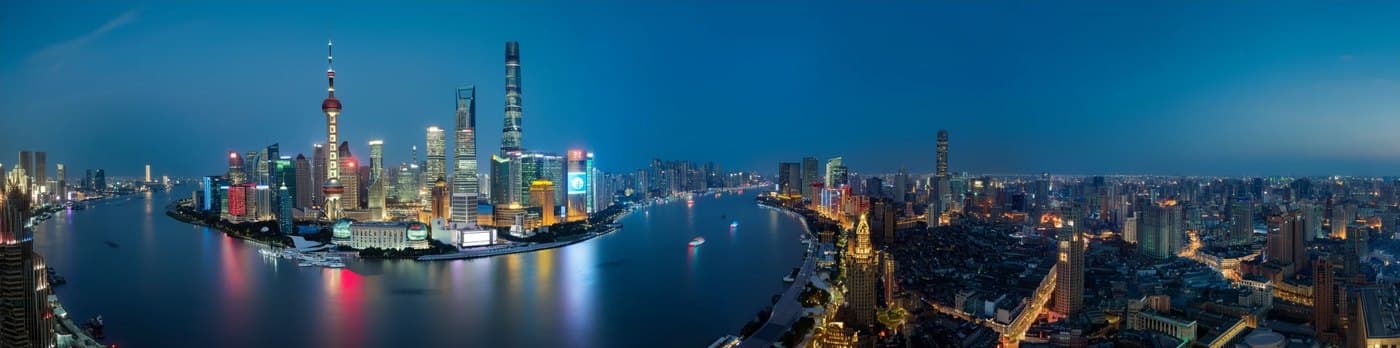
Ce que MOSS-Image fait bien, et là où il peine
De longs textes qui se lisent sans fautes
Sur le benchmark de texte long d'OpenMOSS (LLTB), MOSS-Image obtient 96.3, au niveau de Nano Banana Pro (96.6) et loin devant des modèles ouverts comme Qwen Image 2512 (64.9) et Z-Image Base (40.8). Les testeurs relèvent peu de fautes d'orthographe en anglais et en japonais.
Des mises en page placées par coordonnées
Un prompt JSON peut attribuer à chaque bloc de texte et à chaque objet sa propre zone. Sur le test de mise en page 7Bench, MOSS-Image atteint 0.88 de mIoU, contre 0.30 à 0.33 pour GPT Image 2, Nano Banana Pro, Seedream 5.0 Pro et Qwen Image 3.0 Pro.
Assez léger pour un seul GPU grand public
Avec les fichiers 8 bits, le modèle 5B a tourné sur une RTX 4070 de 12 GB lors de tests de la communauté, et les versions 4 bits ou GGUF tournent sur des cartes de 8 GB avec déchargement (offloading).
Conçu pour être affiné
Le modèle Base est livré sans post-entraînement. KohakuMossTrainer et DiffSynth-Studio entraînent déjà des LoRA, et la communauté a publié des versions en 8 étapes et en 4 étapes.
Lent avec les réglages par défaut
50 étapes, avec deux passes chacune, prennent environ 27 secondes par image 1024 × 1024 sur une RTX 5090 en pleine précision, et environ 50 secondes sur une RTX 4070 de 12 GB avec les fichiers 8 bits.
Points faibles connus
Les utilisateurs signalent des bandes de couleur verticales sur les images SFT, des arrière-plans flous, des mains déformées, du texte en trop que personne n'a demandé et des erreurs de comptage. Il ne sait pas retoucher d'images.
MOSS-Image face à Qwen Image 2.1, Nano Banana Pro et GPT Image 2
Les scores de benchmark proviennent du rapport technique de MOSS-Image (arXiv 2610.23374) et ont été mesurés par OpenMOSS lui-même ; Qwen Image 2.1 n'en faisait pas partie. Les crédits correspondent aux prix de Nano AI au 20 octobre 2026.
| MOSS-Image | Qwen Image 2.1 | Nano Banana Pro | GPT Image 2 | |
|---|---|---|---|---|
| Développeur | OpenMOSS | Alibaba | OpenAI | |
| Poids | Ouverts, Apache 2.0 | Ouverts | Fermés | Fermés |
| Score en texte long (LLTB) | 96.3 | Non testé | 96.6 | 99.0 |
| Elo de préférence humaine (RLA) | 1698.7, avec un prompt enrichi par GPT-6 | Non testé | 1590.2 | 1844.4 |
| Retouche d'images | Non | Oui | Oui | Oui |
| Où le faire tourner | Sur votre propre GPU | Nano AI, 8 crédits | Nano AI, 32 crédits | Nano AI, 12 crédits |
Comment faire tourner MOSS-Image
- 1
Dans ComfyUI
Mettez ComfyUI à jour en version 0.42.0 ou ultérieure, téléchargez le modèle de diffusion, l'encodeur de texte Qwen3.5-9B et le VAE FLUX.2 depuis Comfy-Org/MOSS-Image, puis ouvrez un template MOSS-Image. Notre guide ComfyUI MOSS-Image, en lien ci-dessous, détaille chaque fichier et chaque réglage.
- 2
Avec Python
Sur un GPU NVIDIA, installez diffusers 0.38 ou ultérieur et chargez OpenMOSS-Team/MOSS-Image-SFT avec le pipeline personnalisé fourni. SGLang et vLLM-Omni peuvent aussi servir le modèle.
- 3
Sans GPU
Essayez la démo gratuite d'OpenMOSS sur Hugging Face Spaces, où il peut y avoir une file d'attente, ou le générateur en haut de cette page, qui fait tourner Qwen Image 2.1, le modèle auquel MOSS-Image est le plus souvent comparé.
Conseils de prompt pour MOSS-Image
Écrivez en anglais quand c'est possible, car c'est la langue la mieux représentée dans les données d'entraînement, mettez les mots exacts entre guillemets et ajoutez des retours à la ligne là où vous les voulez. Les quatre premiers prompts fonctionnent aussi dans le générateur ci-dessus.
Note manuscrite en chinois
A wide view of a refrigerator beside a kitchen counter with a fruit bowl. A small sticky note on the refrigerator door is handwritten in Chinese: "记得买牛奶和鸡蛋! 牛奶两盒,鸡蛋一打。 顺便带一袋面包。"
Enseigne bilingue
A small tea shop at dusk with a wooden sign that reads "山间茶舍" on the first line and "Mountain Tea House" on the second line, warm lantern light, wet stone steps, no people
Notes sur un tableau blanc
A glass whiteboard in a bright office with neat handwritten notes in blue marker: "Q4 plan 1. Ship the layout editor 2. Train a style LoRA 3. Publish the user guide", soft daylight, no people
Titre d'affiche
A minimalist travel poster with a cream background, a blue mountain illustration, and the title "EXPLORE" at the top.
Liste de tags (MOSS-Image)
best quality, highres, scenery, mountain lake, sunrise, mist, no humans
FAQ
FAQ MOSS-Image
Des réponses courtes au sujet du modèle, de la façon de le faire tourner et d'une alternative similaire en ligne.
MOSS-Image est-il gratuit ?
Oui. Les poids et le code sont gratuits sous licence Apache 2.0, y compris pour un usage commercial. Vous ne payez que le GPU sur lequel vous le faites tourner. OpenMOSS propose aussi une démo gratuite sur Hugging Face Spaces.
Peut-on utiliser MOSS-Image en ligne sans GPU ?
La démo Hugging Face d'OpenMOSS est la seule option officielle, et il peut y avoir une file d'attente. Nano AI n'héberge pas MOSS-Image ; le générateur de cette page fait tourner Qwen Image 2.1, qui en est proche pour le texte dans les images et sait aussi retoucher des photos. Dans la plupart des régions, les nouveaux comptes reçoivent 16 crédits offerts, de quoi générer 2 images.
De combien de VRAM MOSS-Image a-t-il besoin ?
OpenMOSS n'a pas publié de chiffre. Lors de tests de la communauté, les fichiers en pleine précision ont atteint un pic d'environ 29 GiB sur une RTX 5090, et les fichiers 8 bits environ 16 GiB sur la même carte et environ 11.6 GiB sur une RTX 4070 de 12 GB. Les versions 4 bits et GGUF tournent sur des cartes de 8 GB avec déchargement, plus lentement.
MOSS-Image Base ou SFT : lequel télécharger ?
SFT pour créer des images : il est affiné pour mieux regrouper le texte et soigner la mise en page. Base est le checkpoint brut, destiné à l'entraînement de LoRA et à la recherche.
MOSS-Image peut-il retoucher des images ?
Non. Le rapport technique indique qu'il ne prend pas d'images de référence et ne retouche pas d'images, et OpenMOSS précise que la génération à partir de références est encore à l'étude. Pour les retouches, utilisez un modèle comme Qwen Image 2.1 ou Nano Banana 2.1.
ComfyUI prend-il en charge MOSS-Image ?
Oui, nativement depuis ComfyUI 0.42.0, sorti le 18 octobre 2026. La version 0.41.3 ne l'inclut pas. Notre guide ComfyUI MOSS-Image détaille les fichiers, les dossiers et les réglages.
Qui a créé MOSS-Image ?
OpenMOSS, l'équipe de MOSI.AI à l'origine des modèles MOSS, avec des chercheurs de l'université Fudan, de l'université Jiao Tong de Shanghai et du Shanghai Innovation Institute. Le rapport technique porte la référence arXiv 2610.23374.
Nano AI est-il affilié à OpenMOSS ?
Non. Nano AI est un service indépendant. Il renvoie vers les téléchargements officiels d'OpenMOSS et n'héberge pas MOSS-Image.
À découvrir aussi sur Nano AI
Pages associées
Nano AI est un service indépendant, sans lien d'affiliation avec OpenMOSS ou MOSI.AI, et n'est ni approuvé ni sponsorisé par eux. Les informations et les scores de benchmark de MOSS-Image proviennent des fiches modèles, du dépôt GitHub et du rapport technique d'OpenMOSS, consultés le 20 octobre 2026 ; les chiffres sur le matériel sont des mesures de la communauté. Les exemples d'images proviennent de la fiche modèle d'OpenMOSS et sont utilisés sous licence Apache 2.0.