
Обновлено 20 октября 2026 года · ComfyUI 0.42.0+ · Без кастомных нод
Гайд по ComfyUI MOSS-Image: установка, загрузка и запуск
Нативная поддержка ComfyUI MOSS-Image появилась в ComfyUI 0.42.0. В этом гайде — точные файлы, папка для каждого из них, сколько VRAM им нужно, официальные воркфлоу и решения самых частых ошибок.
Нет GPU или времени на загрузку 13 GB?
Попробуйте Qwen Image 2.1 онлайн: похожая отрисовка текста, ничего не нужно устанавливать
Чтобы настроить ComfyUI MOSS-Image, нужно скачать 13 GB и иметь GPU с памятью от 12 GB. Qwen Image 2.1 — модель, с которой MOSS-Image сравнивают чаще всего: обе пишут китайский и английский текст на изображениях, и в прямых сравнениях результаты близки. На Nano AI она работает в браузере за 8 кредитов за изображение и к тому же умеет редактировать фото — MOSS-Image этого не умеет.
- Разработчик
- OpenMOSS
- Дата выхода
- 16 октября 2026 г.
- Доступно на Nano AI
- Qwen Image 2.1 · 8 кредитов за изображение
- Страница обновлена
- 20 октября 2026 г.
Источник: github.com
Что нужно для ComfyUI MOSS-Image
MOSS-Image — открытая модель OpenMOSS для генерации изображений по тексту: диффузионный трансформер на 5B с текстовым энкодером Qwen3.5-9B и FLUX.2 VAE, выпущенный по лицензии Apache 2.0 16 октября 2026 года. Поддержку добавили в ComfyUI в тот же день (pull request 17095), а в стабильный релиз она впервые попала 18 октября, в версии 0.42.0. Версия 0.41.3 и более старые загрузить модель не могут.
С нативной поддержкой кастомные ноды не нужны. Стандартные ноды Load Diffusion Model, CLIP Loader и Load VAE читают перепакованные файлы из Comfy-Org/MOSS-Image, а для JSON-макетов в ComfyUI есть нода MOSS-Image Layout Prompt.
Собственный плагин MOSS-Image от OpenMOSS по-прежнему доступен, если вы хотите загружать оригинальную папку с Hugging Face или сохранить старый воркфлоу на плагине. Для новой установки ComfyUI MOSS-Image выбирайте нативный способ, описанный ниже.
Требования ComfyUI MOSS-Image
- ComfyUI
- 0.42.0 или новее либо ночная сборка с коммитом e087d8f6
- Кастомные ноды
- Для нативного способа не нужны
- Минимальная загрузка
- Около 13 GB: 8-битная модель, 4-битный текстовый энкодер, малый VAE
- Загрузка в полной точности
- Около 30 GB: модель и текстовый энкодер в bf16
- Память GPU
- В тестах сообщества хватало 12 GB с 8-битными файлами; комфортно — от 16 GB
- Настройки шаблона
- 25 шагов, CFG 2.5, er_sde, планировщик simple
- Настройки OpenMOSS
- 50 шагов, CFG 3, Euler, shift 5, skip layer 22
- Разрешение
- От 1 до 2 мегапикселей, стороны кратны 16
- Редактирование изображений
- Модель не поддерживает
- Лицензия
- Apache 2.0
Как установить ComfyUI MOSS-Image
Нативный способ не требует кастомных нод. Команды рассчитаны на установку ComfyUI через git; ComfyUI Desktop обновляется сам, а портативная сборка — через update/update_comfyui.bat.
- 1
Обновите ComfyUI до 0.42.0 или новее
Поддержку MOSS-Image добавили в код 16 октября 2026 года, а в релиз она впервые попала 18 октября, в версии 0.42.0. Обновитесь и заново установите зависимости, чтобы подтянулся новый код текстового энкодера.
cd ComfyUI git pull pip install -r requirements.txt - 2
Скачайте по одному файлу каждого типа
Нужны диффузионная модель, текстовый энкодер и VAE из Comfy-Org/MOSS-Image. Именно эти три файла загружают официальные шаблоны, всего около 13 GB. Hugging Face CLI сразу разложит их по нужным папкам:
pip install -U huggingface_hub hf download Comfy-Org/MOSS-Image \ diffusion_models/moss_image_sft_int8_convrot.safetensors \ text_encoders/qwen3.5_9b_w4a8_gptq.safetensors \ vae/flux2-vae_small.safetensors \ --local-dir ComfyUI/models - 3
Проверьте папки
Каждый файл лежит в своей папке внутри ComfyUI/models. Перезапустите ComfyUI или нажмите R в интерфейсе, чтобы обновить списки моделей.
ComfyUI/models/diffusion_models/moss_image_sft_int8_convrot.safetensors ComfyUI/models/text_encoders/qwen3.5_9b_w4a8_gptq.safetensors ComfyUI/models/vae/flux2-vae_small.safetensors - 4
Откройте шаблон ComfyUI MOSS-Image
Откройте Templates, найдите MOSS-Image и выберите один из четырёх официальных воркфлоу: MOSS-Image Text to Image, MOSS-Image Base Text to Image или Layout-Guided-версию любого из них.
- 5
Проверьте загрузчики и запустите
В Load Diffusion Model выберите файл moss_image, в CLIP Loader — файл qwen3.5_9b с типом moss_image, в Load VAE — flux2-vae_small. Напишите промпт и нажмите Run. В шаблонах стоят 25 шагов, CFG 2.5 и er_sde; эталонные настройки OpenMOSS — 50 шагов, CFG 3, Euler, shift 5 и skip layer 22.
- 6
Необязательно: плагин OpenMOSS для оригинальной папки
Чтобы вместо этого загружать полную папку с Hugging Face (около 27 GB), установите плагин MOSS-Image через ComfyUI Manager или подключите его скриптом ниже, а затем укажите эту папку в ноде MOSS-Image HF Loader.
git clone https://github.com/OpenMOSS/MOSS-Image.git
cd MOSS-Image
python comfyui/install.py --comfy-root /path/to/ComfyUI
Файлы модели ComfyUI MOSS-Image
Все файлы лежат в Comfy-Org/MOSS-Image на Hugging Face (Apache 2.0). Выберите одну диффузионную модель, один текстовый энкодер и один VAE. Размеры указаны по состоянию на 20 октября 2026 года.
| Файл | Папка в ComfyUI/models | Размер | Когда выбирать |
|---|---|---|---|
| moss_image_sft_int8_convrot.safetensors | diffusion_models | 5.41 GB | По умолчанию в официальных шаблонах: дообученная модель в 8 битах |
| moss_image_sft_bf16.safetensors | diffusion_models | 10.2 GB | Дообученная модель в полной точности, если хватает VRAM |
| moss_image_base_int8_convrot.safetensors | diffusion_models | 5.41 GB | Base-модель в 8 битах — для LoRA, обученных на Base |
| moss_image_base_bf16.safetensors | diffusion_models | 10.2 GB | Base-модель в полной точности — для обучения и исследований |
| qwen3.5_9b_w4a8_gptq.safetensors | text_encoders | 7.34 GB | Самый компактный текстовый энкодер, его используют официальные шаблоны |
| qwen3.5_9b_int8_convrot.safetensors | text_encoders | 9.75 GB | Текстовый энкодер в 8 битах |
| qwen3.5_9b_bf16.safetensors | text_encoders | 19.3 GB | Текстовый энкодер в полной точности |
| flux2-vae_small.safetensors | vae | 250 MB | Малый декодер, который идёт в комплекте с официальным пайплайном и шаблонами |
| flux2-vae.safetensors | vae | 336 MB | Полный FLUX.2 VAE |
Что рисует MOSS-Image
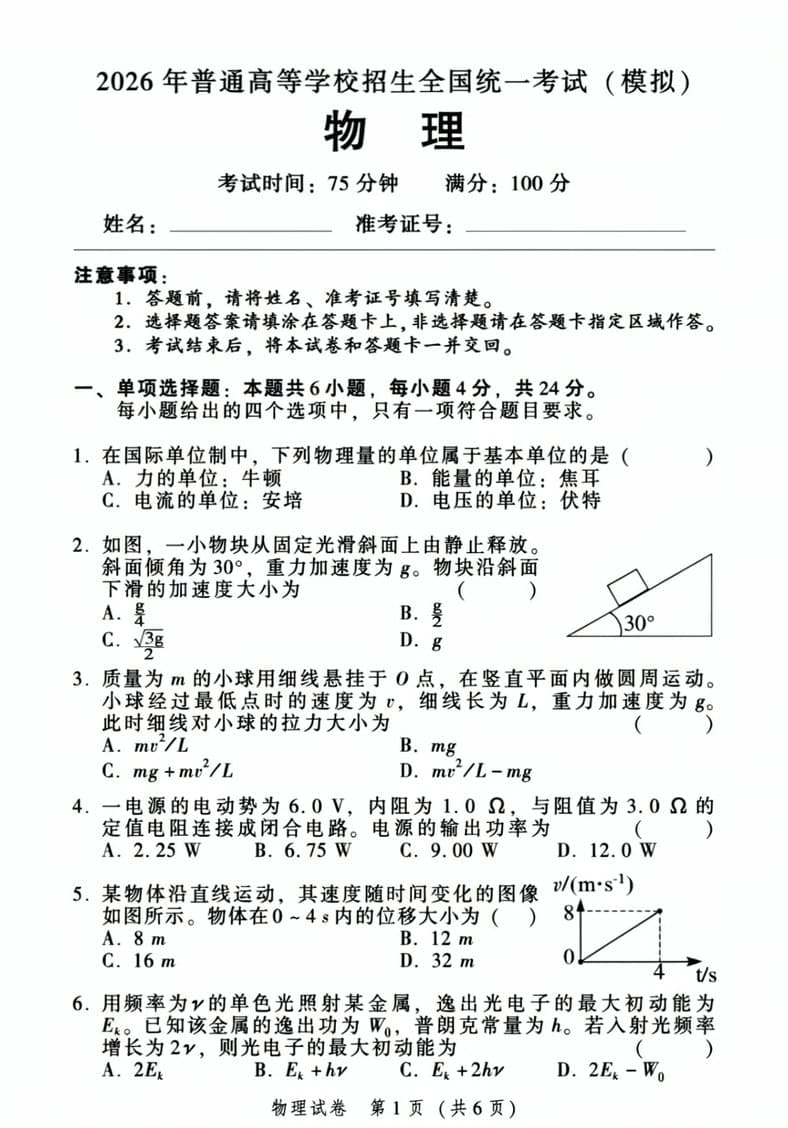
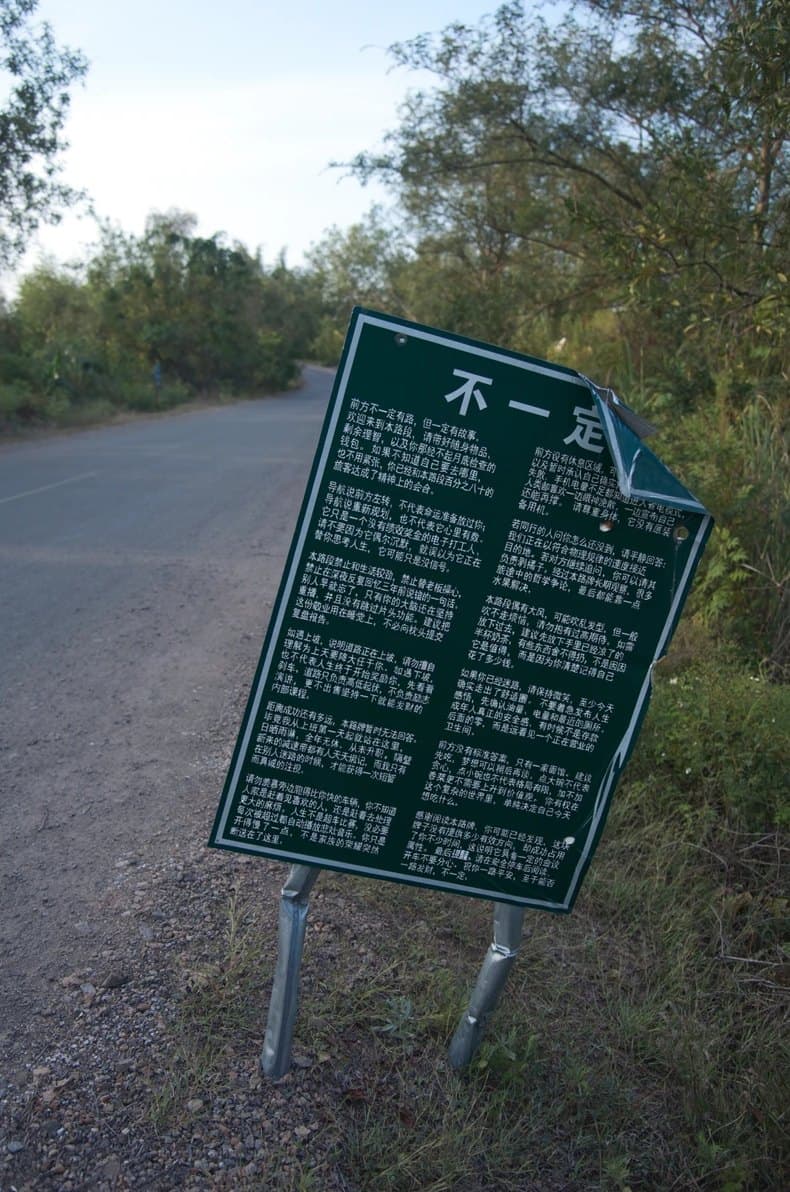
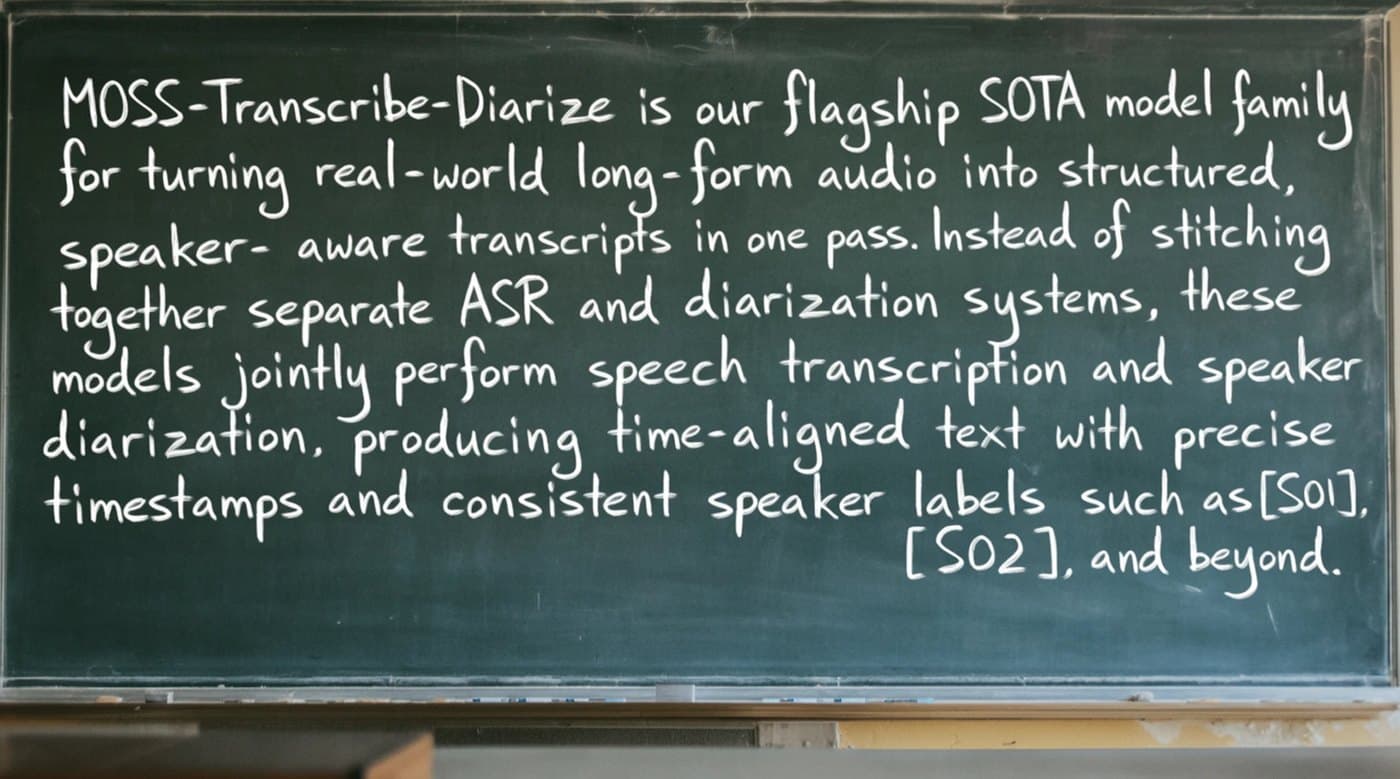
Плотный китайский и английский текст — то, в чём MOSS-Image выделяется. Эти фрагменты вырезаны из демонстрационных изображений в карточке модели OpenMOSS и не ретушировались; промпты не опубликованы, поэтому подписи описывают изображение.
Рекомендуемые настройки ComfyUI MOSS-Image
Шаги: от 25 до 50
OpenMOSS рекомендует 50 и больше. В шаблонах ComfyUI стоит 25 с сэмплером er_sde — это примерно вдвое быстрее.
CFG: от 2.5 до 6
3 — официальное значение по умолчанию, его хватает для длинных промптов; для коротких поднимайте. 8- и 4-шаговые LoRA используют CFG 1.
Shift: 5
Уже встроен в нативную модель. Если меняете его, используйте ModelSamplingAuraFlow с множителем 1, а не ModelSamplingSD3.
Skip layer guidance: слой 22
Пропуск слоя 22 на негативном проходе улучшает детализацию; слои 24 и 26 тоже подходят. Без него картинка выглядит фотографичнее, но детали могут разваливаться.
Разрешение: от 1 до 2 мегапикселей
От 1024 × 1024 примерно до 1456 × 1456, в любом соотношении сторон, стороны кратны 16. Модель справляется с размерами от 512 × 512 до 2K.
Негативный промпт: короткие теги
Оставьте его пустым или используйте теги качества из руководства OpenMOSS: worst quality, bad anatomy, watermark, jpeg artifact.
Скорость и VRAM ComfyUI MOSS-Image в тестах сообщества
OpenMOSS не публиковала данные о VRAM. Это замеры, которыми делились на YouTube, note.com, X и Hugging Face в первую неделю после выхода; пиковая память указана для всего GPU.
| Файлы модели | Размер и шаги | Время на изображение | Пик VRAM | |
|---|---|---|---|---|
| RTX 5090, полная точность | SFT bf16 | 1024 × 1024, 50 шагов | 27.4 с | 29.2 GiB |
| RTX 5090, 8 бит | SFT int8 | 1024 × 1024, 50 шагов | 10.5 с | 16.4 GiB |
| RTX 5090, шаги из шаблона | int8 | 1 мегапиксель, 25 шагов | 5.7 с | Нет данных |
| RTX 4070 12 GB | Base int8, текстовый энкодер int8 | 832 × 1216, 50 шагов | 50–52 с | 11.6 GiB |
| RTX 3060 Ti 8 GB | int8 | 720p, 50 шагов | 52 с | Нет данных |
| DGX Spark | Нет данных | 1024 × 1024, 25 и 50 шагов | 30 с и 48 с | Нет данных |
Воркфлоу, инструменты и туториалы для ComfyUI MOSS-Image
Сначала официальные источники, затем проекты сообщества; всё проверено 20 октября 2026 года.
Как писать промпты для ComfyUI MOSS-Image
- 1
Опишите сцену на английском
Для английского больше всего обучающих данных. Опишите объект, обстановку, освещение и стиль; промпт может занимать до 4096 токенов.
- 2
Возьмите нужный текст в кавычки
Заключите точную формулировку в кавычки и поставьте переносы там, где должны разрываться строки. Работают и китайский, и английский.
- 3
Расставьте элементы по макету
Для постеров и страниц используйте шаблон Layout-Guided или JSON-макет: общее описание плюс элементы с рамками в пикселях, отсчитанными от центра холста.
Промпты для старта в ComfyUI MOSS-Image
Вставьте их в позитивный промпт, а помеченный — в негативный. Пример макета рассчитан на холст 1024 × 1024.
JSON-макет (официальный пример)
{"summary": {"meta": ["poster"], "canvas": "single", "caption": "A minimalist travel poster with a cream background, a blue mountain illustration, and the title EXPLORE at the top."}, "items": [{"label": "text", "caption": "Large dark-blue uppercase title centered at the top.", "text": "EXPLORE", "bbox": [-416, -384, -288, 384]}, {"label": "object", "caption": "A flat blue mountain illustration in the lower center.", "bbox": [-192, -288, 384, 288]}], "bbox_coord_space": "abs_centralized", "bbox_format": "yxyx"}
Печатная страница с формулами
A printed physics exam page in Chinese titled "物理" with numbered multiple-choice questions, a small diagram of a block on a 30° slope and the footer "物理试卷 第1页(共6页)", flat scan, black ink on white paper
Порядок тегов
best quality, highres, scenery, night city, river, skyline reflections, long exposure, no humans
Негативный промпт (теги качества)
worst quality, bad anatomy, watermark, jpeg artifact
Ошибки ComfyUI MOSS-Image и как их исправить
Проблемы, о которых чаще всего сообщали в первые дни после выхода, и что помогло их решить.
- В CLIP Loader нет типа moss_image
- Ваш ComfyUI старше 0.42.0; в 0.41.3 поддержки MOSS-Image нет. Обновитесь, снова выполните pip install -r requirements.txt и перезапустите.
- Странные результаты после перехода с плагина
- Воркфлоу плагина используют ModelSamplingSD3 с другой шкалой таймстепов. Не меняйте загрузчики, а откройте нативный шаблон; shift меняйте через ModelSamplingAuraFlow с множителем 1.
- Серые, блёклые изображения
- Уберите --use-sage-attention из параметров запуска. Пользователи на странице модели Comfy-Org сообщают, что этот флаг обесцвечивает результаты MOSS-Image.
- Не хватает памяти
- Используйте 8-битную модель, 4-битный текстовый энкодер и flux2-vae_small, держитесь около 1 мегапикселя и дайте ComfyUI выгружать модели или запускайте его с --lowvram.
- Вертикальные полосы на изображениях SFT
- Известная проблема SFT. Попробуйте DeBand LoRA от сообщества, исправление от Kijai с отрицательным весом или Base-модель.
- Чёрные изображения
- Обычно это переполнение fp16 на высоком разрешении. Запускайте в bf16 или используйте FP16-fixed-веса от KBlueLeaf.
- Очень медленная генерация
- 50 шагов со skip layer guidance — это два прохода на каждый шаг. Используйте 25 шагов из шаблона, 8- или 4-шаговую LoRA при CFG 1 или ноды Spectrum.
- Неправильные или пропущенные слова
- Берите точный текст в кавычки, ставьте переносы там, где должны разрываться строки, остальную часть промпта пишите на английском, а для коротких промптов поднимайте CFG до 4–6.
- Референс ни на что не влияет
- MOSS-Image не умеет использовать референсы. В шаблонах ref_image подаётся только в необязательный модуль улучшения промпта.
- Тот же сид, но изображение не как в Python
- Так и должно быть. Планировщик ComfyUI не выравнивает шаги по обучающей сетке, как это делает пайплайн на Python, поэтому результаты различаются.
Нет GPU или времени на загрузку 13 GB?
Попробуйте Qwen Image 2.1 онлайн: похожая отрисовка текста, ничего не нужно устанавливать
Чтобы настроить ComfyUI MOSS-Image, нужно скачать 13 GB и иметь GPU с памятью от 12 GB. Qwen Image 2.1 — модель, с которой MOSS-Image сравнивают чаще всего: обе пишут китайский и английский текст на изображениях, и в прямых сравнениях результаты близки. На Nano AI она работает в браузере за 8 кредитов за изображение и к тому же умеет редактировать фото — MOSS-Image этого не умеет.
Вопросы и ответы
Вопросы и ответы о ComfyUI MOSS-Image
Короткие ответы на самые частые вопросы о запуске MOSS-Image в ComfyUI.
Какая версия ComfyUI поддерживает MOSS-Image?
0.42.0, вышедшая 18 октября 2026 года, или ночная сборка начиная с 16 октября (коммит e087d8f6). 0.41.3 её не поддерживает, хотя в некоторых гайдах написано обратное.
Нужна ли кастомная нода для MOSS-Image в ComfyUI?
Нет. Начиная с 0.42.0 стандартные загрузчики читают файлы из Comfy-Org/MOSS-Image. Плагин OpenMOSS нужен только для загрузки оригинальной папки с Hugging Face.
Сколько VRAM нужно ComfyUI MOSS-Image?
Официальной цифры нет. С 8-битной моделью и 4-битным текстовым энкодером в тестах сообщества работала карта на 12 GB, а на картах с 8 GB запускаются 4-битные или GGUF-сборки с выгрузкой — медленно. В полной точности пик на RTX 5090 составил около 29 GiB.
Есть ли версия MOSS-Image в GGUF или fp8?
От OpenMOSS и Comfy-Org — нет: они выпускают файлы в 8 битах (int8) и 4 битах (w4a8). GGUF-файлы от сообщества существуют, но требуют дополнительных кастомных нод, а в Comfy-Org заявили, что нативной поддержки GGUF не будет.
Куда класть файлы ComfyUI MOSS-Image?
В ComfyUI/models: файлы moss_image — в diffusion_models, файлы qwen3.5_9b — в text_encoders, файлы flux2-vae — в vae.
Base или SFT для ComfyUI MOSS-Image?
SFT — для повседневных изображений. Base — для обучения LoRA или если LoRA обучали на Base.
Может ли ComfyUI MOSS-Image редактировать изображения или использовать референс?
Нет, модель только генерирует изображения по тексту. Для правок на Nano AI есть Qwen Image 2.1 и Nano Banana 2.1 — они принимают до 5 референсов.
Можно ли получить похожий результат, ничего не устанавливая?
Да. Попробуйте демо OpenMOSS на Hugging Face или Qwen Image 2.1 на Nano AI — модель, с которой MOSS-Image чаще всего сравнивают по тексту на изображениях. Новые аккаунты в большинстве регионов получают 16 бесплатных кредитов — этого хватит на 2 изображения Qwen Image 2.1.
Ещё на Nano AI
Страницы по теме
Nano AI — независимый сервис и не связан с OpenMOSS, MOSI.AI или Comfy Org. Названия файлов, размеры и версии взяты с Hugging Face, GitHub и из примечаний к релизам ComfyUI по состоянию на 20 октября 2026 года; данные о скорости и VRAM — замеры сообщества. Примеры изображений взяты из карточки модели OpenMOSS и используются по лицензии Apache 2.0.