
OpenMOSS · Вышла 16 октября 2026 года · Apache 2.0
MOSS-Image — открытая модель для текста и макетов на изображениях
MOSS-Image — модель OpenMOSS с открытыми весами на 5B параметров: она создаёт изображения по тексту, пишет на них длинные надписи на китайском и английском и следует JSON-макетам. Ниже — характеристики, результаты бенчмарков, примеры изображений и способы запуска.
MOSS-Image запускают на собственном GPU, поэтому Nano AI её не размещает. Чаще всего её сравнивают с Qwen Image 2.1 — эта модель так же нацелена на китайский и английский текст на изображениях. Именно она работает в генераторе на этой странице: 8 кредитов за изображение, GPU не нужен.
16 бесплатных кредитов = 2 стандартных изображения. Карта не нужна.
Доска результатов
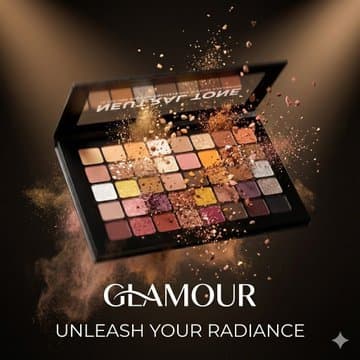
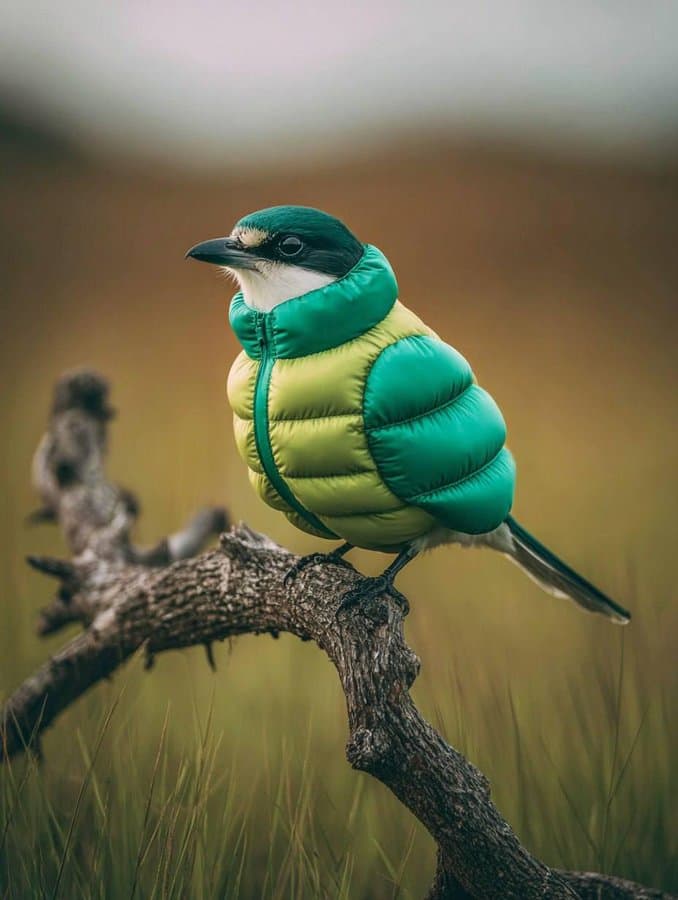
Здесь появятся сгенерированные варианты.
- Разработчик
- OpenMOSS
- Дата выхода
- 16 октября 2026 г.
- Доступно на Nano AI
- Qwen Image 2.1 · 8 кредитов за изображение
- Страница обновлена
- 20 октября 2026 г.
Источник: github.com
Что такое MOSS-Image?
MOSS-Image — модель генерации изображений по тексту, которую OpenMOSS (MOSI.AI) выпустила 16 октября 2026 года вместе с исследователями из Фуданьского университета, Шанхайского университета Цзяо Тун и Шанхайского института инноваций. В ней диффузионный трансформер на 5 миллиардов параметров, обученный с нуля, работает в паре с языковой моделью Qwen3.5-9B в роли текстового энкодера и с FLUX.2 VAE.
Модель выпущена в виде двух чекпоинтов. MOSS-Image-Base оставлен без постобучения, чтобы его было легко дообучать; MOSS-Image-SFT дообучен на отобранных данных ради более чистого текста и макета. Оба распространяются по лицензии Apache 2.0, которая разрешает коммерческое использование.
MOSS-Image только превращает текст в изображения: в техническом отчёте сказано, что она не принимает референсы и не редактирует фото. Чтобы ею пользоваться, нужно скачать веса — около 13 GB в компактных файлах для ComfyUI или 27 GB в полной точности — и запустить их в ComfyUI, Diffusers, SGLang или vLLM-Omni. Если вам просто нужны изображения с чистым китайским и английским текстом, генератор вверху этой страницы запускает Qwen Image 2.1 прямо в браузере.
Характеристики MOSS-Image
- Разработчик
- OpenMOSS (MOSI.AI)
- Дата выхода
- 16 октября 2026 года
- Лицензия
- Apache 2.0, коммерческое использование разрешено
- Модель изображений
- Однопоточный диффузионный трансформер на 5B, 42 блока
- Текстовый энкодер
- Qwen3.5-9B (замороженный)
- VAE
- FLUX.2 VAE с малым декодером
- Чекпоинты
- MOSS-Image-Base и MOSS-Image-SFT
- Форматы промптов
- Обычный текст, списки тегов и JSON-макеты (экспериментально), до 4096 токенов
- Разрешение
- Рекомендуется от 1 до 2 мегапикселей; от 512 × 512 до 2K, стороны кратны 16
- Редактирование изображений
- Не поддерживается
- Сэмплинг по умолчанию
- Euler, 50 шагов, CFG 3, shift 5, skip layer 22
- На Nano AI
- Не размещена; вместо неё работает Qwen Image 2.1, 8 кредитов за изображение
Примеры MOSS-Image
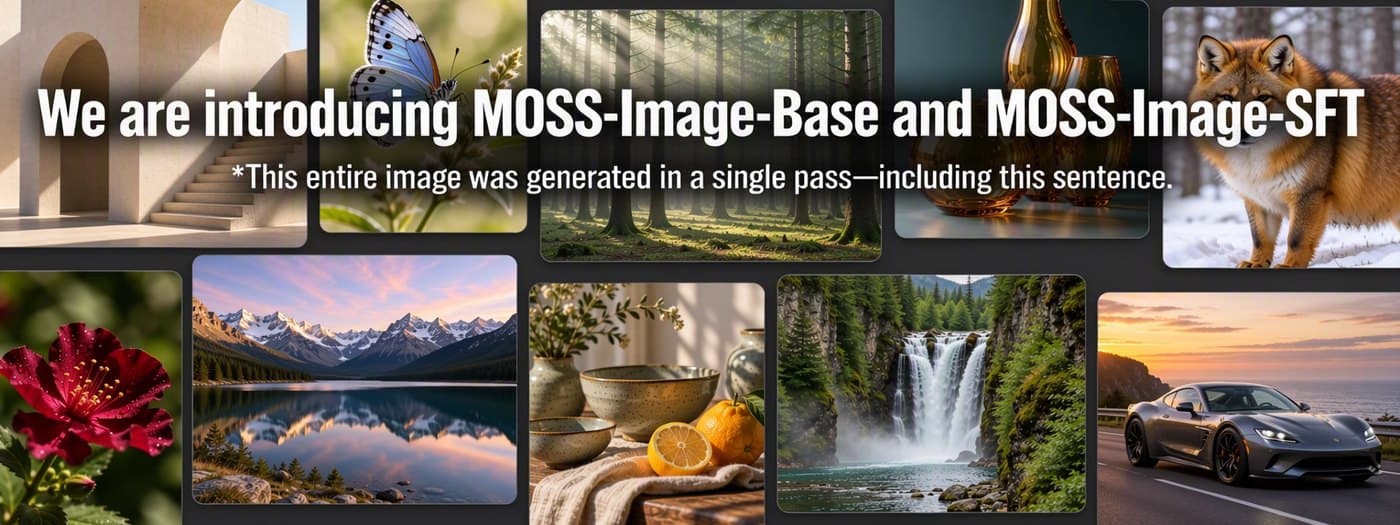
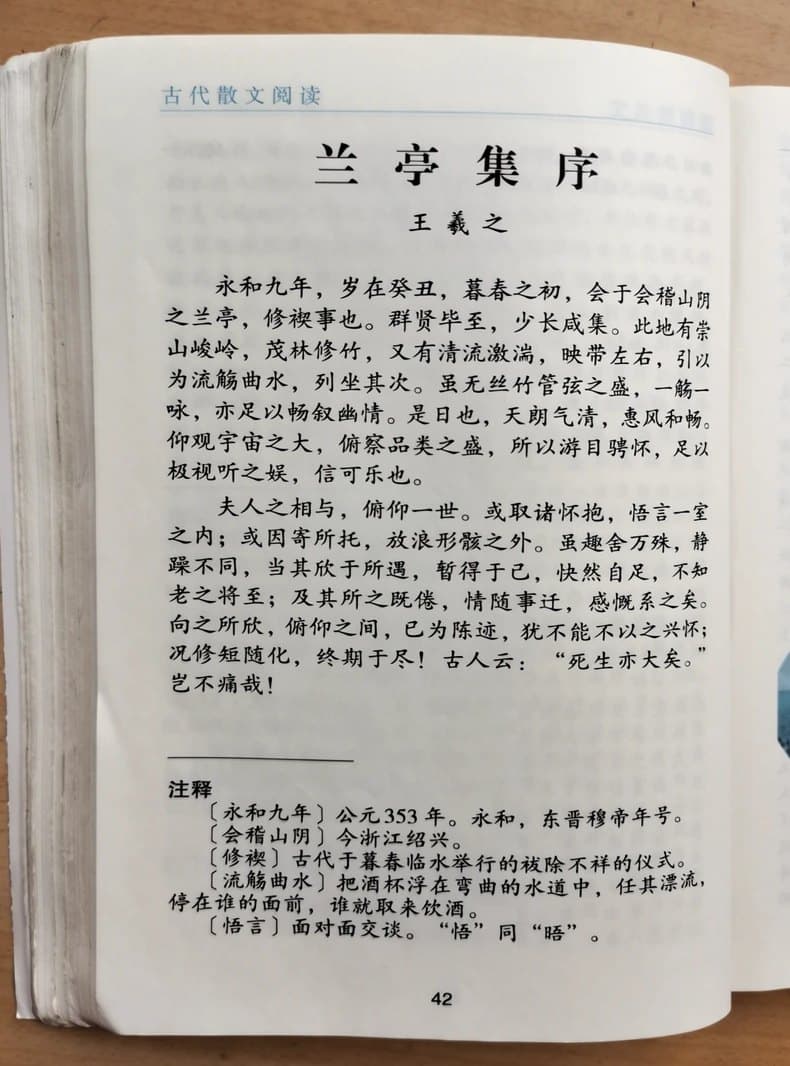
Фрагменты демонстрационных изображений из карточки модели OpenMOSS, без ретуши. Промпты OpenMOSS не опубликовала, поэтому подписи описывают само изображение.
В чём MOSS-Image сильна, а где ей трудно
Длинный текст без искажений
В бенчмарке длинного текста от OpenMOSS (LLTB) MOSS-Image набирает 96.3 — наравне с Nano Banana Pro (96.6) и далеко впереди открытых моделей вроде Qwen Image 2512 (64.9) и Z-Image Base (40.8). Тестировщики отмечают мало орфографических ошибок в английском и японском.
Макет по координатам
В JSON-промпте каждому текстовому блоку и объекту можно задать собственную рамку. В тесте макетов 7Bench MOSS-Image достигает 0.88 mIoU против 0.30–0.33 у GPT Image 2, Nano Banana Pro, Seedream 5.0 Pro и Qwen Image 3.0 Pro.
Хватает одной потребительской видеокарты
С 8-битными файлами модель на 5B в тестах сообщества запускалась на RTX 4070 с 12 GB, а 4-битные и GGUF-версии работают на картах с 8 GB с выгрузкой (offloading).
Создана для дообучения
Base-модель поставляется без постобучения. KohakuMossTrainer и DiffSynth-Studio уже обучают LoRA, а сообщество выложило 8-шаговые и 4-шаговые версии.
Медленная на настройках по умолчанию
50 шагов по два прохода на каждом — это около 27 секунд на изображение 1024 × 1024 на RTX 5090 в полной точности и около 50 секунд на RTX 4070 с 12 GB с 8-битными файлами.
Известные слабые места
Пользователи сообщают о вертикальных цветных полосах на изображениях SFT, размытом фоне, искажённых руках, лишнем тексте, о котором никто не просил, и трудностях с подсчётом объектов. Редактировать изображения модель не умеет.
MOSS-Image в сравнении с Qwen Image 2.1, Nano Banana Pro и GPT Image 2
Результаты бенчмарков взяты из технического отчёта MOSS-Image (arXiv 2610.23374), тесты проводила сама OpenMOSS; Qwen Image 2.1 в них не участвовала. Кредиты — цены Nano AI на 20 октября 2026 года.
| MOSS-Image | Qwen Image 2.1 | Nano Banana Pro | GPT Image 2 | |
|---|---|---|---|---|
| Разработчик | OpenMOSS | Alibaba | OpenAI | |
| Веса | Открытые, Apache 2.0 | Открытые | Закрытые | Закрытые |
| Длинный текст (LLTB) | 96.3 | Не тестировалась | 96.6 | 99.0 |
| Предпочтения людей, Elo (RLA) | 1698.7, с улучшением промпта через GPT-6 | Не тестировалась | 1590.2 | 1844.4 |
| Редактирование изображений | Нет | Да | Да | Да |
| Где запускать | Свой GPU | Nano AI, 8 кредитов | Nano AI, 32 кредита | Nano AI, 12 кредитов |
Как запустить MOSS-Image
- 1
В ComfyUI
Обновите ComfyUI до 0.42.0 или новее, скачайте из Comfy-Org/MOSS-Image диффузионную модель, текстовый энкодер Qwen3.5-9B и FLUX.2 VAE и откройте шаблон MOSS-Image. В нашем гайде по ComfyUI MOSS-Image (ссылка ниже) перечислены все файлы и настройки.
- 2
Через Python
На GPU NVIDIA установите diffusers 0.38 или новее и загрузите OpenMOSS-Team/MOSS-Image-SFT с прилагаемым кастомным пайплайном. Развернуть модель как сервис можно также через SGLang и vLLM-Omni.
- 3
Без GPU
Попробуйте бесплатное демо OpenMOSS на Hugging Face Spaces (там бывает очередь) или генератор вверху этой страницы — он запускает Qwen Image 2.1, модель, с которой MOSS-Image сравнивают чаще всего.
Советы по промптам для MOSS-Image
По возможности пишите на английском — на нём больше всего обучающих данных, — берите точные слова в кавычки и ставьте переносы строк там, где они нужны. Первые четыре промпта работают и в генераторе выше.
Рукописная записка на китайском
A wide view of a refrigerator beside a kitchen counter with a fruit bowl. A small sticky note on the refrigerator door is handwritten in Chinese: "记得买牛奶和鸡蛋! 牛奶两盒,鸡蛋一打。 顺便带一袋面包。"
Двуязычная вывеска
A small tea shop at dusk with a wooden sign that reads "山间茶舍" on the first line and "Mountain Tea House" on the second line, warm lantern light, wet stone steps, no people
Заметки на доске
A glass whiteboard in a bright office with neat handwritten notes in blue marker: "Q4 plan 1. Ship the layout editor 2. Train a style LoRA 3. Publish the user guide", soft daylight, no people
Заголовок постера
A minimalist travel poster with a cream background, a blue mountain illustration, and the title "EXPLORE" at the top.
Список тегов (MOSS-Image)
best quality, highres, scenery, mountain lake, sunrise, mist, no humans
Вопросы и ответы
Вопросы и ответы о MOSS-Image
Короткие ответы о модели, её запуске и похожих вариантах онлайн.
MOSS-Image бесплатна?
Да. Веса и код бесплатны по лицензии Apache 2.0, в том числе для коммерческого использования. Платить нужно только за GPU, на котором вы её запускаете. Кроме того, у OpenMOSS есть бесплатное демо на Hugging Face Spaces.
Можно ли пользоваться MOSS-Image онлайн без GPU?
Единственный официальный вариант — демо OpenMOSS на Hugging Face, и в нём бывает очередь. Nano AI не размещает MOSS-Image; генератор на этой странице запускает Qwen Image 2.1 — по тексту на изображениях она близка к MOSS-Image и к тому же умеет редактировать фото. Новые аккаунты в большинстве регионов получают 16 бесплатных кредитов — этого хватит на 2 изображения.
Сколько VRAM нужно MOSS-Image?
OpenMOSS эту цифру не публиковала. В тестах сообщества файлы в полной точности занимали в пике около 29 GiB на RTX 5090, 8-битные — около 16 GiB на той же карте и около 11.6 GiB на RTX 4070 с 12 GB. 4-битные и GGUF-версии работают на картах с 8 GB с выгрузкой, но медленнее.
MOSS-Image Base или SFT: что скачать?
SFT — для создания изображений: она дообучена ради более аккуратной группировки текста и макета. Base — нетронутый чекпоинт для обучения LoRA и исследований.
Может ли MOSS-Image редактировать изображения?
Нет. В техническом отчёте сказано, что модель не принимает референсы и не редактирует изображения, а генерацию по референсам OpenMOSS, по её словам, ещё изучает. Для правок используйте модель вроде Qwen Image 2.1 или Nano Banana 2.1.
Поддерживает ли ComfyUI MOSS-Image?
Да, нативно — начиная с ComfyUI 0.42.0, версии от 18 октября 2026 года. В версии 0.41.3 поддержки нет. В нашем гайде по ComfyUI MOSS-Image перечислены файлы, папки и настройки.
Кто создал MOSS-Image?
OpenMOSS — команда MOSI.AI, которая стоит за моделями MOSS, вместе с исследователями из Фуданьского университета, Шанхайского университета Цзяо Тун и Шанхайского института инноваций. Технический отчёт — arXiv 2610.23374.
Связан ли Nano AI с OpenMOSS?
Нет. Nano AI — независимый сервис. Он ссылается на официальные загрузки OpenMOSS и не размещает MOSS-Image.
Ещё на Nano AI
Страницы по теме
Nano AI — независимый сервис; он не связан с OpenMOSS или MOSI.AI, не одобрен и не спонсируется ими. Сведения о MOSS-Image и результаты бенчмарков взяты из карточек модели, репозитория на GitHub и технического отчёта OpenMOSS по состоянию на 20 октября 2026 года; данные о железе — замеры сообщества. Примеры изображений взяты из карточки модели OpenMOSS и используются по лицензии Apache 2.0.