
Atualizado em 20 de outubro de 2026 · ComfyUI 0.42.0+ · Sem nós personalizados
Guia do ComfyUI MOSS-Image: instalar, baixar e rodar
O ComfyUI MOSS-Image tem suporte nativo desde o ComfyUI 0.42.0. Este guia lista os arquivos exatos, a pasta de cada um, quanta VRAM eles exigem, os workflows oficiais e as soluções para os erros mais frequentes.
Sem GPU, ou sem tempo para baixar 13 GB?
Teste o Qwen Image 2.1 online: renderização de texto parecida, sem instalar nada
Configurar o ComfyUI MOSS-Image exige baixar 13 GB e ter uma GPU com 12 GB ou mais. O Qwen Image 2.1 é o modelo com que o MOSS-Image é mais comparado: os dois escrevem texto em chinês e inglês dentro das imagens, e testes lado a lado mostram resultados próximos. No Nano AI, ele roda no seu navegador por 8 créditos por imagem e também edita fotos, o que o MOSS-Image não faz.
- Desenvolvido por
- OpenMOSS
- Lançamento
- 16 de outubro de 2026
- Disponível no Nano AI
- Qwen Image 2.1 · 8 créditos por imagem
- Página atualizada
- 20 de outubro de 2026
Fonte: github.com
O que você precisa para o ComfyUI MOSS-Image
O MOSS-Image é o modelo aberto de texto para imagem da OpenMOSS: um transformer de difusão de 5B com o codificador de texto Qwen3.5-9B e o VAE do FLUX.2, lançado sob Apache 2.0 em 16 de outubro de 2026. O suporte foi incorporado ao ComfyUI no mesmo dia (pull request 17095) e saiu pela primeira vez na versão estável 0.42.0, em 18 de outubro. A versão 0.41.3 e as anteriores não conseguem carregá-lo.
Com o suporte nativo, você não precisa de nós personalizados. Os nós padrão Load Diffusion Model, CLIP Loader e Load VAE leem os arquivos reempacotados de Comfy-Org/MOSS-Image, e o ComfyUI adiciona um nó MOSS-Image Layout Prompt para layouts em JSON.
O plugin MOSS-Image da própria OpenMOSS continua disponível se você quiser carregar a pasta original do Hugging Face ou manter um workflow antigo do plugin. Para uma nova configuração do ComfyUI MOSS-Image, siga o caminho nativo abaixo.
Requisitos do ComfyUI MOSS-Image
- ComfyUI
- 0.42.0 ou mais recente, ou uma build nightly com o commit e087d8f6
- Nós personalizados
- Nenhum no caminho nativo
- Menor download
- Cerca de 13 GB: modelo de 8 bits, codificador de texto de 4 bits, VAE pequeno
- Download em precisão total
- Cerca de 30 GB: modelo e codificador de texto em bf16
- Memória da GPU
- 12 GB funcionaram com os arquivos de 8 bits em testes da comunidade; com 16 GB ou mais, sobra folga
- Configurações do template
- 25 passos, CFG 2.5, er_sde, scheduler simple
- Configurações da OpenMOSS
- 50 passos, CFG 3, Euler, shift 5, skip layer 22
- Resolução
- De 1 a 2 megapixels, com lados em múltiplos de 16
- Edição de imagens
- Sem suporte no modelo
- Licença
- Apache 2.0
Como instalar o ComfyUI MOSS-Image
O caminho nativo não precisa de nós personalizados. Os comandos supõem uma instalação do ComfyUI via git; o ComfyUI Desktop se atualiza sozinho, e a versão portátil se atualiza com update/update_comfyui.bat.
- 1
Atualize o ComfyUI para a 0.42.0 ou mais recente
O suporte ao MOSS-Image foi incorporado em 16 de outubro de 2026 e saiu pela primeira vez na 0.42.0, em 18 de outubro. Atualize e instale os requisitos de novo para que o código do novo codificador de texto esteja no lugar.
cd ComfyUI git pull pip install -r requirements.txt - 2
Baixe um arquivo de cada tipo
Você precisa de um modelo de difusão, um codificador de texto e um VAE de Comfy-Org/MOSS-Image. Estes três são os que os templates oficiais carregam, cerca de 13 GB no total. A CLI do Hugging Face coloca os arquivos direto nas pastas certas:
pip install -U huggingface_hub hf download Comfy-Org/MOSS-Image \ diffusion_models/moss_image_sft_int8_convrot.safetensors \ text_encoders/qwen3.5_9b_w4a8_gptq.safetensors \ vae/flux2-vae_small.safetensors \ --local-dir ComfyUI/models - 3
Confira as pastas
Cada arquivo fica na sua própria pasta dentro de ComfyUI/models. Reinicie o ComfyUI ou aperte R na interface para atualizar as listas de modelos.
ComfyUI/models/diffusion_models/moss_image_sft_int8_convrot.safetensors ComfyUI/models/text_encoders/qwen3.5_9b_w4a8_gptq.safetensors ComfyUI/models/vae/flux2-vae_small.safetensors - 4
Abra um template do ComfyUI MOSS-Image
Abra Templates, pesquise MOSS-Image e escolha um dos quatro workflows oficiais: MOSS-Image Text to Image, MOSS-Image Base Text to Image ou a versão Layout-Guided de qualquer um dos dois.
- 5
Confira os loaders e rode
No Load Diffusion Model, escolha o arquivo moss_image; no CLIP Loader, o arquivo qwen3.5_9b, com o tipo definido como moss_image; e no Load VAE, o flux2-vae_small. Escreva um prompt e clique em Run. Os templates usam 25 passos, CFG 2.5 e er_sde; as configurações de referência da OpenMOSS são 50 passos, CFG 3, Euler, shift 5 e skip layer 22.
- 6
Opcional: o plugin da OpenMOSS para a pasta original
Para carregar a pasta completa do Hugging Face (cerca de 27 GB), instale o plugin MOSS-Image pelo ComfyUI Manager, ou crie o link com o script abaixo, e depois aponte o nó MOSS-Image HF Loader para a pasta.
git clone https://github.com/OpenMOSS/MOSS-Image.git
cd MOSS-Image
python comfyui/install.py --comfy-root /path/to/ComfyUI
Arquivos do modelo para o ComfyUI MOSS-Image
Todos os arquivos estão em Comfy-Org/MOSS-Image, no Hugging Face (Apache 2.0). Escolha um modelo de difusão, um codificador de texto e um VAE. Tamanhos conforme listados em 20 de outubro de 2026.
| Arquivo | Pasta em ComfyUI/models | Tamanho | Quando escolher |
|---|---|---|---|
| moss_image_sft_int8_convrot.safetensors | diffusion_models | 5.41 GB | O padrão dos templates oficiais: o modelo com ajuste fino em 8 bits |
| moss_image_sft_bf16.safetensors | diffusion_models | 10.2 GB | O modelo com ajuste fino em precisão total, se você tiver VRAM para isso |
| moss_image_base_int8_convrot.safetensors | diffusion_models | 5.41 GB | O modelo Base em 8 bits, para LoRAs treinadas no Base |
| moss_image_base_bf16.safetensors | diffusion_models | 10.2 GB | O modelo Base em precisão total, para treinamento e pesquisa |
| qwen3.5_9b_w4a8_gptq.safetensors | text_encoders | 7.34 GB | O menor codificador de texto, usado pelos templates oficiais |
| qwen3.5_9b_int8_convrot.safetensors | text_encoders | 9.75 GB | O codificador de texto em 8 bits |
| qwen3.5_9b_bf16.safetensors | text_encoders | 19.3 GB | O codificador de texto em precisão total |
| flux2-vae_small.safetensors | vae | 250 MB | O decodificador pequeno que vem com o pipeline e os templates oficiais |
| flux2-vae.safetensors | vae | 336 MB | O VAE completo do FLUX.2 |
O que o MOSS-Image renderiza
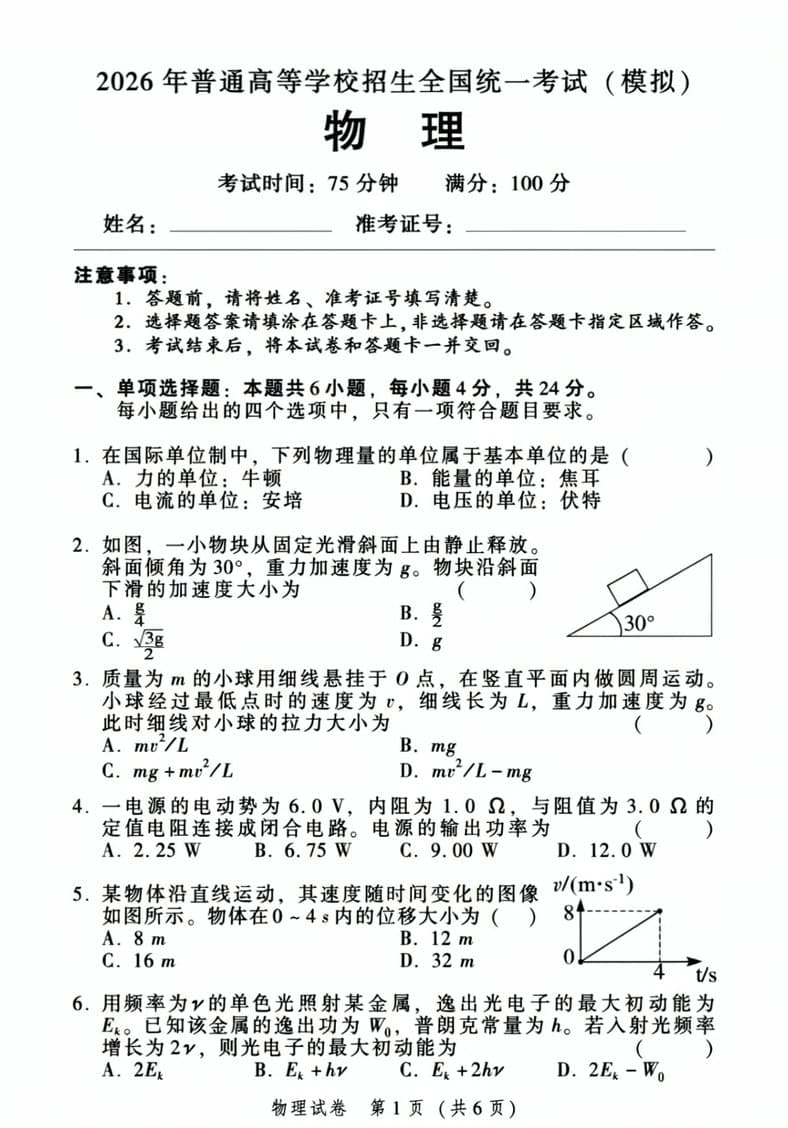
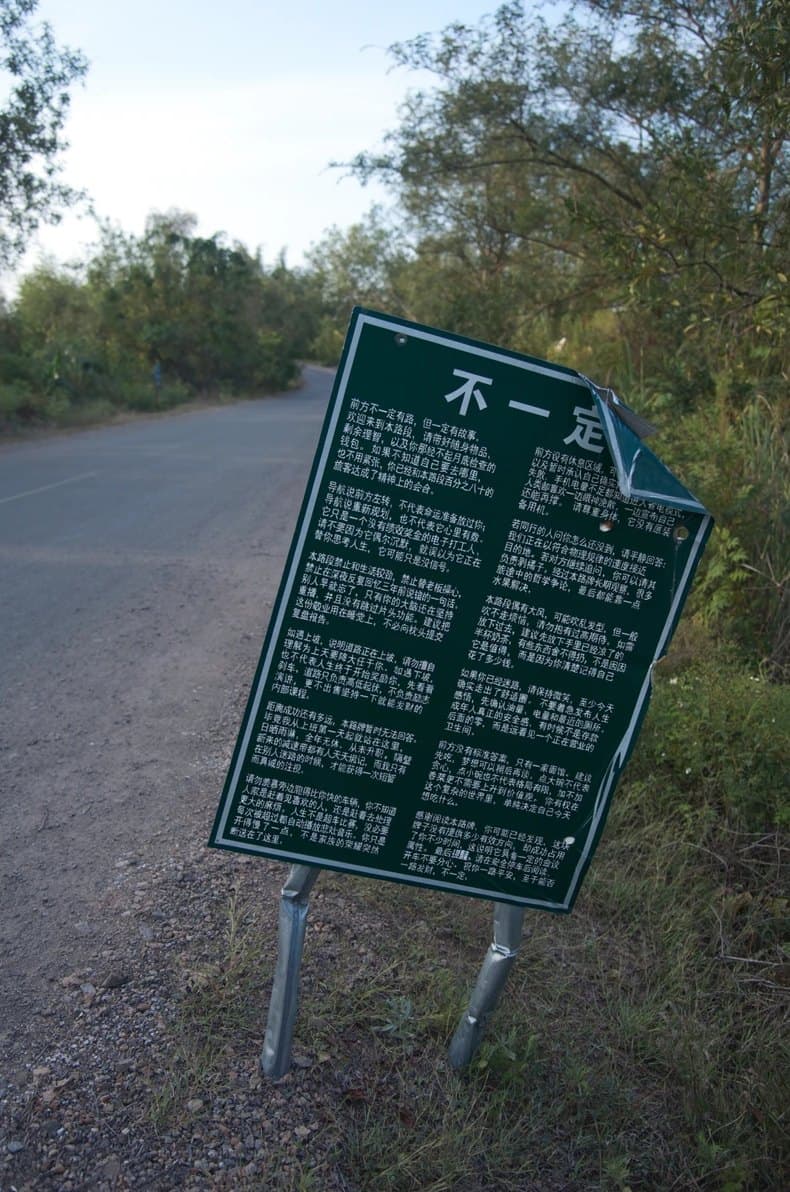
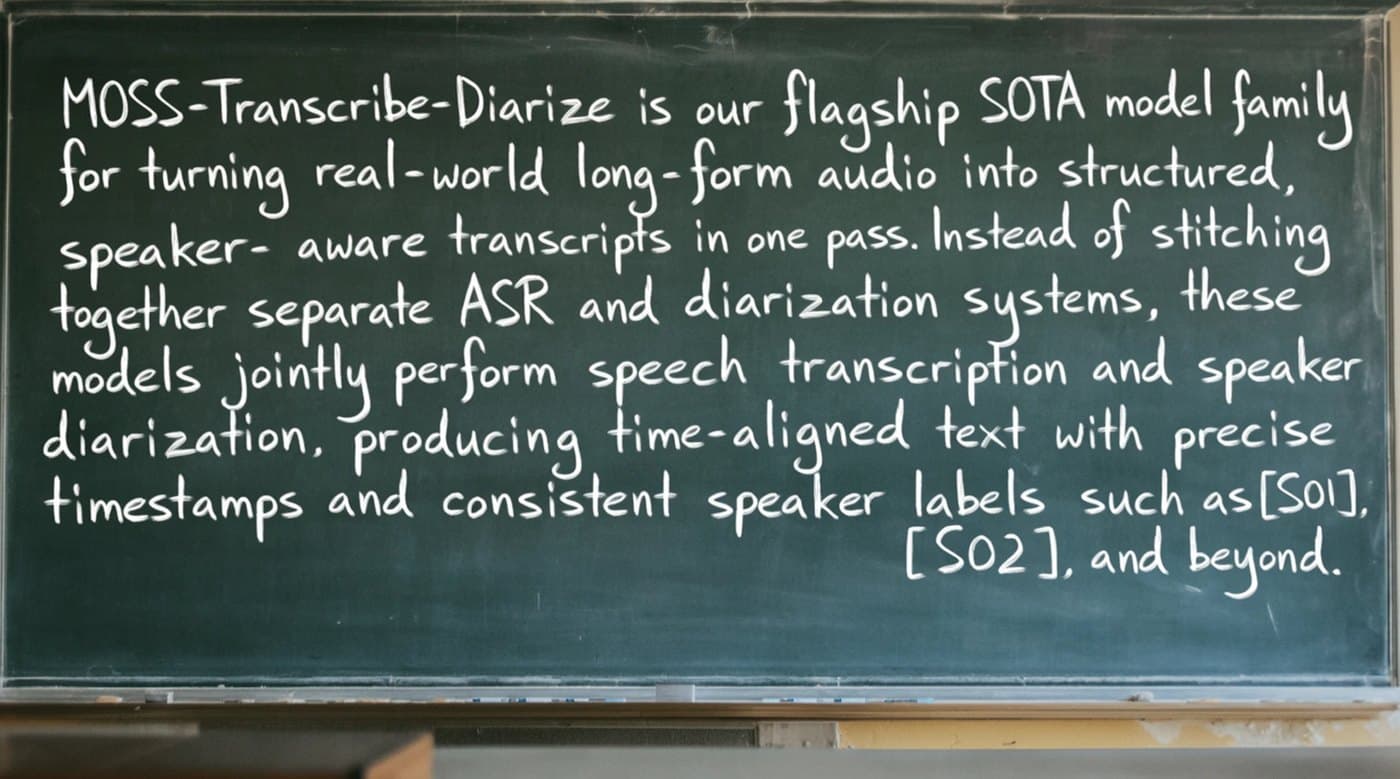
Texto denso em chinês e inglês é onde o MOSS-Image se destaca. Estas imagens foram recortadas da galeria do model card da OpenMOSS, sem retoques; os prompts não foram publicados, então cada legenda descreve a imagem.
Configurações recomendadas para o ComfyUI MOSS-Image
Passos: 25 a 50
A OpenMOSS recomenda 50 ou mais. Os templates do ComfyUI usam 25 com o sampler er_sde, o que leva cerca de metade do tempo.
CFG: 2.5 a 6
3 é o padrão oficial e basta para prompts longos; aumente para prompts curtos. As LoRAs de 8 e de 4 passos usam CFG 1.
Shift: 5
Já vem embutido no modelo nativo. Se você mudar, use o ModelSamplingAuraFlow com multiplier 1, não o ModelSamplingSD3.
Skip layer guidance: camada 22
Pular a camada 22 na passada negativa melhora os detalhes; as camadas 24 e 26 também funcionam. Desligada, a imagem fica com aspecto mais fotográfico, mas os detalhes podem se desfazer.
Resolução: 1 a 2 megapixels
De 1024 × 1024 até cerca de 1456 × 1456, em qualquer proporção, com lados em múltiplos de 16. O modelo vai de 512 × 512 até 2K.
Prompt negativo: tags curtas
Deixe vazio ou use as tags de qualidade do guia do usuário da OpenMOSS: worst quality, bad anatomy, watermark, jpeg artifact.
Velocidade e VRAM do ComfyUI MOSS-Image em testes da comunidade
A OpenMOSS não publicou números de VRAM. Estas são medições que as pessoas compartilharam no YouTube, no note.com, no X e no Hugging Face na semana seguinte ao lançamento; o pico de memória é o da GPU inteira.
| Arquivos do modelo | Tamanho e passos | Tempo por imagem | Pico de VRAM | |
|---|---|---|---|---|
| RTX 5090, precisão total | SFT bf16 | 1024 × 1024, 50 passos | 27.4 s | 29.2 GiB |
| RTX 5090, 8 bits | SFT int8 | 1024 × 1024, 50 passos | 10.5 s | 16.4 GiB |
| RTX 5090, passos do template | int8 | 1 megapixel, 25 passos | 5.7 s | Não informado |
| RTX 4070 12 GB | Base int8, codificador de texto int8 | 832 × 1216, 50 passos | 50 a 52 s | 11.6 GiB |
| RTX 3060 Ti 8 GB | int8 | 720p, 50 passos | 52 s | Não informado |
| DGX Spark | Não informado | 1024 × 1024, 25 e 50 passos | 30 s e 48 s | Não informado |
Workflows, ferramentas e tutoriais do ComfyUI MOSS-Image
Primeiro as fontes oficiais, depois os projetos da comunidade, todos verificados em 20 de outubro de 2026.
Como escrever prompts para o ComfyUI MOSS-Image
- 1
Descreva a cena em inglês
O inglês é o idioma com mais dados de treino. Descreva o assunto, o cenário, a iluminação e o estilo; um prompt pode ter até 4,096 tokens.
- 2
Coloque entre aspas o texto que você quer
Coloque o texto exato entre aspas e adicione quebras de linha onde as linhas devem quebrar. Chinês e inglês funcionam.
- 3
Posicione os elementos com um layout
Para pôsteres e páginas, use o template Layout-Guided ou um layout em JSON: uma legenda de resumo mais itens com caixas em pixels, medidas a partir do centro do canvas.
Prompts do ComfyUI MOSS-Image para começar
Cole estes prompts no prompt positivo, ou no negativo quando indicado. O exemplo de layout é para um canvas de 1024 × 1024.
Layout em JSON (exemplo oficial)
{"summary": {"meta": ["poster"], "canvas": "single", "caption": "A minimalist travel poster with a cream background, a blue mountain illustration, and the title EXPLORE at the top."}, "items": [{"label": "text", "caption": "Large dark-blue uppercase title centered at the top.", "text": "EXPLORE", "bbox": [-416, -384, -288, 384]}, {"label": "object", "caption": "A flat blue mountain illustration in the lower center.", "bbox": [-192, -288, 384, 288]}], "bbox_coord_space": "abs_centralized", "bbox_format": "yxyx"}
Página impressa com fórmulas
A printed physics exam page in Chinese titled "物理" with numbered multiple-choice questions, a small diagram of a block on a 30° slope and the footer "物理试卷 第1页(共6页)", flat scan, black ink on white paper
Ordem das tags
best quality, highres, scenery, night city, river, skyline reflections, long exposure, no humans
Prompt negativo (tags de qualidade)
worst quality, bad anatomy, watermark, jpeg artifact
Erros do ComfyUI MOSS-Image e como corrigi-los
Os problemas mais relatados nos primeiros dias após o lançamento e o que os resolveu.
- O CLIP Loader não tem o tipo moss_image
- Seu ComfyUI é anterior à 0.42.0; a 0.41.3 não inclui o MOSS-Image. Atualize, rode pip install -r requirements.txt de novo e reinicie.
- Resultados estranhos depois de migrar do plugin
- Os workflows do plugin usam ModelSamplingSD3, que tem outra escala de timesteps. Abra um template nativo em vez de trocar os loaders e ajuste o shift no ModelSamplingAuraFlow, com multiplier 1.
- Imagens acinzentadas e desbotadas
- Remova --use-sage-attention das opções de inicialização. Usuários na página do modelo da Comfy-Org relatam que essa opção dessatura as imagens do MOSS-Image.
- Falta de memória
- Use o modelo de 8 bits, o codificador de texto de 4 bits e o flux2-vae_small, fique perto de 1 megapixel e deixe o ComfyUI fazer offloading, ou inicie com --lowvram.
- Listras verticais nas imagens do SFT
- Um problema conhecido do SFT. Experimente a LoRA DeBand da comunidade, a correção com peso negativo de Kijai ou o modelo Base.
- Imagens pretas
- Geralmente é overflow do fp16 em alta resolução. Rode em bf16 ou use os pesos FP16-fixed de KBlueLeaf.
- Geração muito lenta
- 50 passos com skip layer guidance significam duas passadas por passo. Use os 25 passos do template, uma LoRA de 8 ou 4 passos com CFG 1, ou os nós Spectrum.
- Palavras erradas ou faltando
- Coloque o texto exato entre aspas, adicione quebras de linha onde as linhas devem quebrar, escreva o resto do prompt em inglês e suba o CFG para algo entre 4 e 6 em prompts curtos.
- A imagem de referência não faz nada
- O MOSS-Image não usa imagens de referência. Nos templates, ref_image só alimenta o aprimorador de prompt opcional.
- Mesma seed, imagem diferente da do Python
- É esperado. O scheduler do ComfyUI não se alinha à grade de treinamento que o pipeline em Python usa, então as saídas são diferentes.
Sem GPU, ou sem tempo para baixar 13 GB?
Teste o Qwen Image 2.1 online: renderização de texto parecida, sem instalar nada
Configurar o ComfyUI MOSS-Image exige baixar 13 GB e ter uma GPU com 12 GB ou mais. O Qwen Image 2.1 é o modelo com que o MOSS-Image é mais comparado: os dois escrevem texto em chinês e inglês dentro das imagens, e testes lado a lado mostram resultados próximos. No Nano AI, ele roda no seu navegador por 8 créditos por imagem e também edita fotos, o que o MOSS-Image não faz.
Perguntas frequentes
Perguntas frequentes sobre o ComfyUI MOSS-Image
Respostas curtas para o que as pessoas mais perguntam sobre rodar o MOSS-Image no ComfyUI.
Qual versão do ComfyUI é compatível com o MOSS-Image?
A 0.42.0, lançada em 18 de outubro de 2026, ou uma build nightly a partir de 16 de outubro (commit e087d8f6). A 0.41.3 não é compatível, embora alguns guias digam que sim.
Preciso de um nó personalizado para o MOSS-Image no ComfyUI?
Não. Desde a 0.42.0, os loaders padrão leem os arquivos de Comfy-Org/MOSS-Image. O plugin da OpenMOSS só é necessário para carregar a pasta original do Hugging Face.
De quanta VRAM o ComfyUI MOSS-Image precisa?
Não há número oficial. Com o modelo de 8 bits e o codificador de texto de 4 bits, uma placa de 12 GB funcionou em testes da comunidade, e placas de 8 GB rodam configurações de 4 bits ou GGUF com offloading, devagar. Em precisão total, o pico foi de cerca de 29 GiB em uma RTX 5090.
Existe versão GGUF ou fp8 do MOSS-Image?
Não da OpenMOSS nem da Comfy-Org, que distribuem arquivos de 8 bits (int8) e de 4 bits (w4a8). Existem arquivos GGUF da comunidade, mas eles exigem nós personalizados extras, e a Comfy-Org já disse que o GGUF não terá suporte nativo.
Onde ficam os arquivos do ComfyUI MOSS-Image?
Dentro de ComfyUI/models: os arquivos moss_image em diffusion_models, os qwen3.5_9b em text_encoders e os flux2-vae em vae.
Base ou SFT no ComfyUI MOSS-Image?
SFT para as imagens do dia a dia. Base para treinar LoRAs, ou quando uma LoRA foi treinada no Base.
O ComfyUI MOSS-Image edita imagens ou usa imagem de referência?
Não, ele só gera imagens a partir de texto. Para edições, o Qwen Image 2.1 e o Nano Banana 2.1 no Nano AI aceitam até 5 imagens de referência.
Dá para ter resultados parecidos sem instalar nada?
Sim. Teste a demo da OpenMOSS no Hugging Face ou o Qwen Image 2.1 no Nano AI, o modelo com que o MOSS-Image é mais comparado em texto nas imagens. Contas novas na maioria das regiões recebem 16 créditos grátis, o suficiente para 2 imagens do Qwen Image 2.1.
Mais do Nano AI
Páginas relacionadas
O Nano AI é um serviço independente e não é afiliado à OpenMOSS, à MOSI.AI nem à Comfy Org. Nomes de arquivos, tamanhos e versões vêm do Hugging Face, do GitHub e das notas de versão do ComfyUI, conforme consultados em 20 de outubro de 2026; os números de velocidade e VRAM são medições da comunidade. As imagens de exemplo vêm do model card da OpenMOSS e são usadas sob a licença Apache 2.0.