
OpenMOSS · Lançado em 16 de outubro de 2026 · Apache 2.0
MOSS-Image: o modelo aberto para texto e layout em imagens
O MOSS-Image é um modelo de texto para imagem da OpenMOSS, com 5B de parâmetros e pesos abertos. Ele escreve textos longos em chinês e inglês dentro das imagens e segue layouts em JSON. Abaixo: especificações, pontuações em benchmarks, imagens de exemplo e como rodar o modelo.
O MOSS-Image roda na sua própria GPU, por isso o Nano AI não o hospeda. O modelo com que ele é mais comparado é o Qwen Image 2.1, que tem o mesmo foco em texto em chinês e inglês nas imagens. É ele que este gerador usa: 8 créditos por imagem, sem precisar de GPU.
16 créditos grátis = 2 imagens padrão. Não precisa de cartão.
Painel de resultados
As variações geradas aparecem aqui.
- Desenvolvido por
- OpenMOSS
- Lançamento
- 16 de outubro de 2026
- Disponível no Nano AI
- Qwen Image 2.1 · 8 créditos por imagem
- Página atualizada
- 20 de outubro de 2026
Fonte: github.com
O que é o MOSS-Image?
O MOSS-Image é um modelo de texto para imagem lançado pela OpenMOSS (MOSI.AI) em 16 de outubro de 2026, com pesquisadores da Universidade Fudan, da Universidade Jiao Tong de Xangai e do Shanghai Innovation Institute. Ele combina um transformer de difusão de 5 bilhões de parâmetros, treinado do zero, com o modelo de linguagem Qwen3.5-9B como codificador de texto e com o VAE do FLUX.2.
Ele vem em dois checkpoints. O MOSS-Image-Base não passou por pós-treinamento, o que facilita o ajuste fino; o MOSS-Image-SFT recebeu ajuste fino com dados selecionados para gerar texto e layout mais limpos. Os dois são distribuídos sob a licença Apache 2.0, que permite uso comercial.
O MOSS-Image só transforma texto em imagens: segundo o relatório técnico, ele não aceita imagens de referência nem edita fotos. Para usá-lo, você baixa os pesos, cerca de 13 GB nos arquivos compactos do ComfyUI ou 27 GB em precisão total, e roda o modelo no ComfyUI, no Diffusers, no SGLang ou no vLLM-Omni. Se você só quer imagens com texto limpo em chinês e inglês, o gerador no topo desta página roda o Qwen Image 2.1 no navegador.
Especificações do MOSS-Image
- Desenvolvedor
- OpenMOSS (MOSI.AI)
- Lançamento
- 16 de outubro de 2026
- Licença
- Apache 2.0, uso comercial permitido
- Modelo de imagem
- Transformer de difusão de fluxo único, com 5B e 42 blocos
- Codificador de texto
- Qwen3.5-9B (congelado)
- VAE
- VAE do FLUX.2 com o decodificador pequeno
- Checkpoints
- MOSS-Image-Base e MOSS-Image-SFT
- Formatos de prompt
- Linguagem natural, listas de tags e layouts em JSON (experimental), até 4,096 tokens
- Resolução
- Recomendado: de 1 a 2 megapixels; de 512 × 512 até 2K, com lados em múltiplos de 16
- Edição de imagens
- Sem suporte
- Amostragem padrão
- Euler, 50 passos, CFG 3, shift 5, skip layer 22
- No Nano AI
- Não hospedado; no lugar dele roda o Qwen Image 2.1, a 8 créditos por imagem
Exemplos do MOSS-Image
Imagens recortadas da galeria do model card da OpenMOSS, sem retoques. A OpenMOSS não publicou os prompts, então cada legenda descreve a imagem.
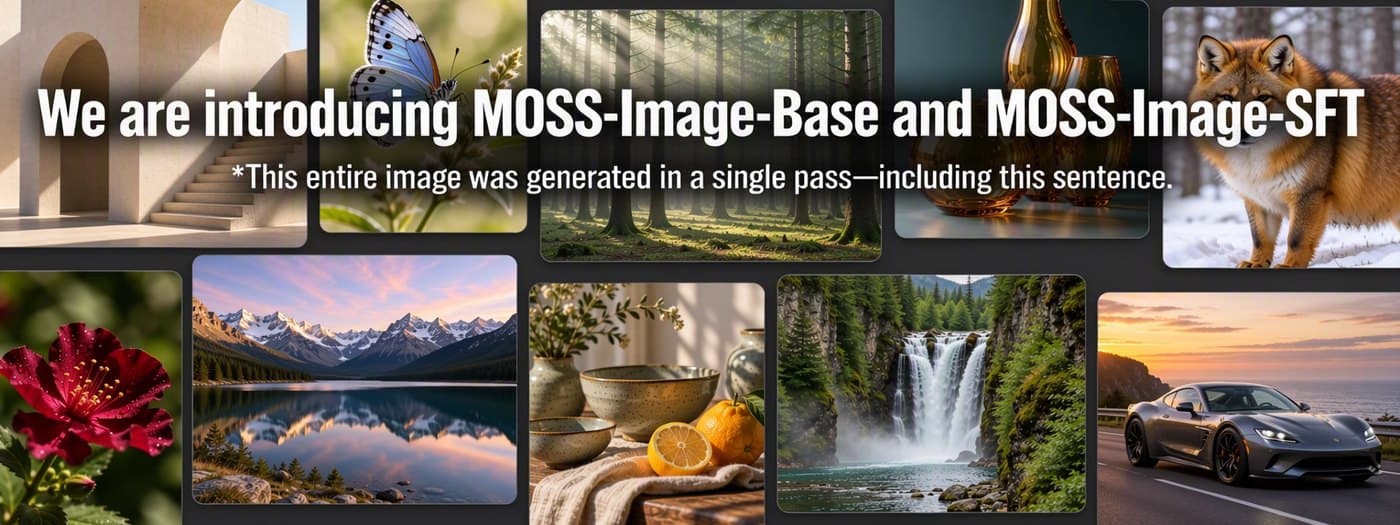
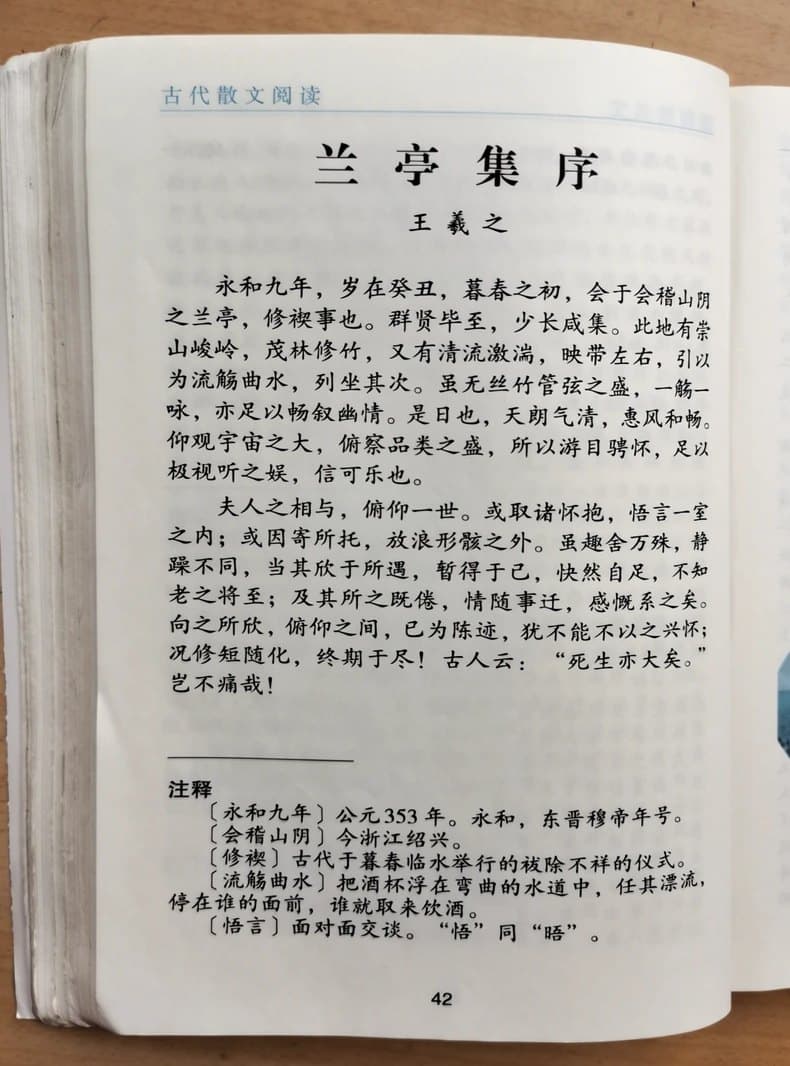
Onde o MOSS-Image se sai bem e onde tem dificuldades
Textos longos escritos corretamente
No benchmark de texto longo da OpenMOSS (LLTB), o MOSS-Image marca 96.3, no mesmo nível do Nano Banana Pro (96.6) e bem à frente de modelos abertos como o Qwen Image 2512 (64.9) e o Z-Image Base (40.8). Quem testou relata poucos erros de grafia em inglês e em japonês.
Layouts posicionados por coordenadas
Um prompt em JSON pode dar a cada bloco de texto e a cada objeto a sua própria caixa. No teste de layout 7Bench, o MOSS-Image chega a 0.88 de mIoU, contra 0.30 a 0.33 do GPT Image 2, do Nano Banana Pro, do Seedream 5.0 Pro e do Qwen Image 3.0 Pro.
Cabe em uma única GPU de consumo
Com os arquivos de 8 bits, o modelo de 5B rodou em uma RTX 4070 de 12 GB em testes da comunidade, e as versões de 4 bits ou GGUF rodam em placas de 8 GB com offloading.
Feito para ajuste fino
O modelo Base é distribuído sem pós-treinamento. O KohakuMossTrainer e o DiffSynth-Studio já treinam LoRAs, e a comunidade publicou versões de 8 e de 4 passos.
Lento nas configurações padrão
50 passos, com duas passadas cada, levam cerca de 27 segundos por imagem de 1024 × 1024 em uma RTX 5090 em precisão total, e cerca de 50 segundos em uma RTX 4070 de 12 GB com arquivos de 8 bits.
Pontos fracos conhecidos
Usuários relatam faixas verticais de cor nas imagens do SFT, fundos borrados, mãos deformadas, texto extra que ninguém pediu e dificuldade com contagem. Ele não edita imagens.
MOSS-Image vs. Qwen Image 2.1, Nano Banana Pro e GPT Image 2
As pontuações em benchmarks vêm do relatório técnico do MOSS-Image (arXiv 2610.23374) e foram medidas pela própria OpenMOSS; o Qwen Image 2.1 não fez parte da avaliação. Os créditos são preços do Nano AI em 20 de outubro de 2026.
| MOSS-Image | Qwen Image 2.1 | Nano Banana Pro | GPT Image 2 | |
|---|---|---|---|---|
| Desenvolvedor | OpenMOSS | Alibaba | OpenAI | |
| Pesos | Abertos, Apache 2.0 | Abertos | Fechados | Fechados |
| Pontuação em texto longo (LLTB) | 96.3 | Não testado | 96.6 | 99.0 |
| Elo de preferência humana (RLA) | 1698.7, com o GPT-6 como aprimorador de prompt | Não testado | 1590.2 | 1844.4 |
| Edição de imagens | Não | Sim | Sim | Sim |
| Onde rodar | Na sua própria GPU | Nano AI, 8 créditos | Nano AI, 32 créditos | Nano AI, 12 créditos |
Como rodar o MOSS-Image
- 1
No ComfyUI
Atualize para o ComfyUI 0.42.0 ou mais recente, baixe o modelo de difusão, o codificador de texto Qwen3.5-9B e o VAE do FLUX.2 em Comfy-Org/MOSS-Image e abra um template do MOSS-Image. Nosso guia do ComfyUI MOSS-Image, no link abaixo, lista todos os arquivos e configurações.
- 2
Com Python
Em uma GPU NVIDIA, instale o diffusers 0.38 ou mais recente e carregue OpenMOSS-Team/MOSS-Image-SFT com o pipeline personalizado que vem junto. O SGLang e o vLLM-Omni também podem servir o modelo.
- 3
Sem GPU
Teste a demo grátis da OpenMOSS no Hugging Face Spaces, que pode ter fila, ou o gerador no topo desta página, que roda o Qwen Image 2.1, o modelo com que o MOSS-Image é mais comparado.
Dicas de prompt para o MOSS-Image
Escreva em inglês sempre que puder, já que é o idioma com mais dados de treino, coloque as palavras exatas entre aspas e adicione quebras de linha onde quiser. Os quatro primeiros também funcionam no gerador acima.
Bilhete escrito à mão em chinês
A wide view of a refrigerator beside a kitchen counter with a fruit bowl. A small sticky note on the refrigerator door is handwritten in Chinese: "记得买牛奶和鸡蛋! 牛奶两盒,鸡蛋一打。 顺便带一袋面包。"
Placa de loja bilíngue
A small tea shop at dusk with a wooden sign that reads "山间茶舍" on the first line and "Mountain Tea House" on the second line, warm lantern light, wet stone steps, no people
Anotações no quadro branco
A glass whiteboard in a bright office with neat handwritten notes in blue marker: "Q4 plan 1. Ship the layout editor 2. Train a style LoRA 3. Publish the user guide", soft daylight, no people
Título de pôster
A minimalist travel poster with a cream background, a blue mountain illustration, and the title "EXPLORE" at the top.
Lista de tags (MOSS-Image)
best quality, highres, scenery, mountain lake, sunrise, mist, no humans
Perguntas frequentes
Perguntas frequentes sobre o MOSS-Image
Respostas curtas sobre o modelo, sobre como rodá-lo e sobre como usar algo parecido online.
O MOSS-Image é grátis?
Sim. Os pesos e o código são gratuitos sob a licença Apache 2.0, inclusive para uso comercial. Você paga apenas pela GPU em que roda o modelo. A OpenMOSS também mantém uma demo grátis no Hugging Face Spaces.
Posso usar o MOSS-Image online, sem GPU?
A demo da OpenMOSS no Hugging Face é a única opção oficial, e ela pode ter fila. O Nano AI não hospeda o MOSS-Image; o gerador desta página roda o Qwen Image 2.1, que chega perto dele em texto nas imagens e também edita fotos. Contas novas na maioria das regiões recebem 16 créditos grátis, o suficiente para 2 imagens.
De quanta VRAM o MOSS-Image precisa?
A OpenMOSS não publicou um número. Em testes da comunidade, os arquivos em precisão total chegaram a um pico de cerca de 29 GiB em uma RTX 5090; os arquivos de 8 bits, a cerca de 16 GiB na mesma placa e a cerca de 11.6 GiB em uma RTX 4070 de 12 GB. As versões de 4 bits e GGUF rodam em placas de 8 GB com offloading, mais devagar.
MOSS-Image Base ou SFT: qual devo baixar?
O SFT, para criar imagens: ele recebeu ajuste fino para agrupar o texto e organizar o layout de forma mais limpa. O Base é o checkpoint sem modificações, pensado para treinar LoRAs e para pesquisa.
O MOSS-Image edita imagens?
Não. O relatório técnico diz que ele não aceita imagens de referência nem edita imagens, e a OpenMOSS afirma que a geração a partir de referências ainda está em estudo. Para edições, use um modelo como o Qwen Image 2.1 ou o Nano Banana 2.1.
O ComfyUI é compatível com o MOSS-Image?
Sim, de forma nativa desde o ComfyUI 0.42.0, lançado em 18 de outubro de 2026. A versão 0.41.3 não inclui o modelo. Nosso guia do ComfyUI MOSS-Image lista os arquivos, as pastas e as configurações.
Quem criou o MOSS-Image?
A OpenMOSS, a equipe da MOSI.AI por trás dos modelos MOSS, com pesquisadores da Universidade Fudan, da Universidade Jiao Tong de Xangai e do Shanghai Innovation Institute. O relatório técnico é o arXiv 2610.23374.
O Nano AI é afiliado à OpenMOSS?
Não. O Nano AI é um serviço independente. Ele traz links para os downloads oficiais da OpenMOSS e não hospeda o MOSS-Image.
Mais do Nano AI
Páginas relacionadas
O Nano AI é um serviço independente e não é afiliado à OpenMOSS nem à MOSI.AI, nem endossado ou patrocinado por elas. As informações e as pontuações em benchmarks do MOSS-Image vêm dos model cards, do repositório no GitHub e do relatório técnico da OpenMOSS, conforme consultados em 20 de outubro de 2026; os números de hardware são medições da comunidade. As imagens de exemplo vêm do model card da OpenMOSS e são usadas sob a licença Apache 2.0.